Weight decay 也有方向
调 weight decay 时,我们通常先调系数:该设多大,是否随训练阶段变化,不同模块要不要分别设置。这些问题都默认了一件事——衰减方向已经确定。对矩阵权重来说,这个方向其实也可以选择。
AdamW 将任务更新与权重衰减分开:优化器根据梯度决定如何更新,衰减项则直接作用于当前权重。普通 weight decay(下文简称 WD)沿着 收缩;而矩阵的奇异值分解,为衰减方向提供了更多选择。
单独看普通 WD,每个奇异值都会乘上相同的系数。矩阵整体变小了,奇异值之间的比例却没有变化。那么,能否让谱的不同部分受到不同程度的收缩?
谱幂权重衰减(spectral-power weight decay),记作 WD,用一个奇异值幂次来指定这种收缩。对权重矩阵 ,设其秩为 ,紧致 SVD 为 ,其中 的列正交归一, 为非零奇异值。定义
幂次 决定衰减如何随模态大小变化。下文用 表示衰减方向,用 WD 表示采用这一方向的方法。它对应的惩罚为
其中 是 Schatten 范数。 时,; 时, 是核范数的一个次梯度 (Lewis, 1995; Watson, 1992)。普通 WD 对应 。其他幂次则改变大、小奇异值受到的相对衰减,也就是改变对谱头和谱尾的偏好。
接下来要看的是:权重谱改变之后,模型学到的表示会怎样变化,这些变化又是否有助于预测?我们先从一个可解的线性模型入手,再看 Transformer 训练中的结果。
权重谱描述参数大小如何分布在不同奇异模态上;激活谱描述这些权重在数据上产生的表示;验证损失衡量模型的预测表现。
这三类测量相关,却不能互相替代。 WD 作用于权重,而非当前任务梯度。因此,秩发生变化说明它改变了几何结构,但这一变化本身还不能说明模型学得更好。
1. 从普通 weight decay 到解耦优化器
1.1 L2 正则与 weight decay 何时等价
岭回归与 Tikhonov 正则通过二次惩罚控制参数大小 (Hoerl & Kennard, 1970; Tikhonov & Arsenin, 1977):
记 为任务损失, 为 L2 惩罚系数, 为基础步长, 为调度乘子。普通 SGD 的更新为
令 ,L2 正则与 weight decay 就给出了相同的普通 SGD 更新。这个惩罚控制权重的总平方大小,也可以写成
早期关于 weight decay 的分析,就研究了这种范数惩罚如何抑制无关成分、减轻训练目标中噪声的影响 (Krogh & Hertz, 1991)。
1.2 超出普通 SGD,这个区别为何重要
动量对历史梯度做平均 (Sutskever et al., 2013);AdaGrad 与 Adam 还会根据梯度历史,对不同坐标分别缩放 (Duchi et al., 2011; Kingma & Ba, 2015)。记向量化参数为 ,随机任务梯度为 ,预条件算子为 。Adam 的对角缩放来自二阶矩估计的平方根倒数,并带有数值稳定项。暂时略去动量平均,耦合 L2 正则的更新可以示意为
解耦衰减则直接作用于参数:
普通 SGD 中 ,令 就能恢复前面的等价关系。Adam 中,耦合的 L2 项还会进入矩估计,并经过预条件变换。因此,将它移到优化器之外,改变的是算法本身,而不只是记法。这一区别也会影响泛化行为 (Tang et al., 2025; Zou et al., 2023)。
1.3 为衰减保留独立分支
AdamW 明确采用了这种分离 (Loshchilov & Hutter, 2019)。下文将解耦更新统一写成
是优化器根据任务梯度和内部状态计算出的方向。基础系数 、 固定, 对两项进行调度。这里的“解耦”指衰减不经过优化器的预条件和状态更新,并不要求两项采用不同的调度。
对这条衰减分支,已有不少工作研究如何调整强度。AdaDecay 根据梯度统计设置逐参数衰减率 (Nakamura & Hong, 2019);adaptive WD 根据任务更新与 L2 更新的相对大小调整系数 (Ghiasi et al., 2023);AlphaDecay 则为 LLM 的不同模块分配系数,以平衡重尾谱统计 (He et al., 2025)。
这些方法细化了“衰减多少”和“在哪里衰减”。逐参数缩放本身也可能改变更新方向,因此强度与几何并不完全独立。本文关注一个更具体的选择:直接在权重的奇异基上,为不同模态指定收缩规律。
1.4 从矩阵优化器看更新几何
K-FAC、Shampoo、SOAP 和 Muon 已经在利用矩阵结构设计任务更新 (Gupta et al., 2018; Jordan et al., 2024; Martens & Grosse, 2015; Vyas et al., 2025)。Muon 是一个直观的例子:理想化的更新保留动量矩阵的奇异方向,将每个非零奇异值替换为 1 (Jordan et al., 2024)。这个 polar 因子的计算可以用 Polar Express 高效近似 (Amsel et al., 2026)。
类似的矩阵运算也可以用于衰减,但处理的对象不同。Muon 变换任务动量, WD 变换当前权重;前者决定如何利用任务信号,后者决定如何约束参数。
2. 普通 weight decay 控制了什么
2.1 单独衰减改变尺度,不改变归一化谱
先不考虑任务更新。对非零矩阵 ,其中 ,普通 WD 的一步更新为
其中 是当前调度乘子,并假设 。于是
谱范数和 Frobenius 范数都会缩小,但所有奇异值比例保持不变。后面定义的稳定秩和熵有效秩 eRank 也不变。这个结论只针对单独的衰减步。完整训练中,任务更新还会改变奇异值和奇异向量,衰减也会通过与任务更新的交互影响最终谱 (Loshchilov & Hutter, 2019)。
2.2 范数控制仍然可能影响学到的结构
因此,普通 WD 与低秩结构有关,并不与上述结论矛盾。它与优化过程存在多种交互 (Zhang et al., 2019),因子化还会引入另一层作用:模型可能依赖两个权重的乘积,而非某个权重本身。对 query、key 权重 ,令 。当因子维度足以表示 时,有经典关系 (Srebro et al., 2004):
这里 是核范数,最小值取遍相容的因子 。它将因子的二次惩罚与乘积的低秩偏好联系起来。需要留意的是,等式中有一个最小化过程,训练中任意时刻的因子并不一定达到这个最小值。低秩 attention 的相关分析同样需要具体的平衡与动力学条件 (Kobayashi et al., 2024)。
权重范数还会影响有效步长。在尺度不变的参数化中,权重缩放会改变同样一次更新带来的函数变化 (van Laarhoven, 2017)。Hyperball 直接控制权重和优化器更新的 Frobenius 范数 (Wen et al., 2026)。对一个较小的任务更新步,参数空间中的角度变化近似为
其中 是方向在权重球面上的切向分量,。当任务方向的范数受控时, 可作为有效学习率(effective learning rate,ELR)的代理。因此,即使不直接改变谱形状,权重尺度的变化也可能改变学习动态。
2.3 如何读谱:符号与秩指标
对非零 ,将奇异值排序为 ,其中 包括零模态。定义 ;对概率向量 ,令 ,约定 。谱范数为 。表中的 表示保留的主导模态数,归一化谱熵则要求 。
| 指标 | 定义 | 含义 |
|---|---|---|
| 代数秩 (Higham, 2002) | 非零 的数量 | 有效子空间的精确维度 |
| Stable rank (Sanyal et al., 2020) | 相对于最大模态的总平方能量 | |
| 熵有效秩 eRank (Roy & Vetterli, 2007) | , | 携带奇异值质量的有效模态数 |
| 输出能量有效秩 (Roy & Vetterli, 2007) | , | 各向同性输入下承载输出能量的有效模态数 |
| Top- 能量 (Eckart & Young, 1936) | 前 个模态的能量集中度 | |
| 归一化谱熵 (Shannon, 1948) | 相对于均匀谱的熵 |
稳定秩与 eRank 都不受整体缩放影响,但它们概括谱的方式不同:稳定秩比较总平方能量与最大模态,eRank 衡量奇异值质量分布的均匀程度,输出能量有效秩则改用奇异值的平方作为权重。这些都不同于 softmax 后注意力概率的熵 (Roy & Vetterli, 2007; Vaswani et al., 2017; Zhai et al., 2023)。下文提到“秩”时,指的是具体标注的统计量,不一定是代数秩。
3. 谱幂权重衰减:方向、理论与谱塑形
3.1 定义与对应惩罚
要改变所有模态按相同比例收缩的规则,可以将衰减方向中的奇异值替换为它的幂:
三个常用情形是
就是普通 WD。 使用有效 polar 因子,对每个非零模态施加相同大小的绝对衰减。 则让大模态受到更强的绝对和相对衰减。零模态对 的贡献取零,与有效 polar 因子和核范数次微分一致 (Cai et al., 2010; Higham, 1986; Watson, 1992)。
当 时,这个方向是如下酉不变谱惩罚的梯度:
方向中的幂次是 ,Schatten 惩罚的阶数则是 (Lewis, 1995)。 时,惩罚是非光滑的核范数, 是它的一个次梯度 (Cai et al., 2010; Watson, 1992);这一情形也被用于研究如何诱导低秩权重 (Andriianov et al., 2026)。
将这个方向用于解耦更新,得到
这里仍沿用固定基础系数与共享调度的约定。实际比较时需要注意:改变 ,既会改变 的范数,也会改变其在不同模态上的分配。因此,不同幂次使用相同数值的 ,并不意味着衰减强度相同。
3.2 如何计算 WD
对整数 ,这个方向可以不经过 SVD 来计算。设 分别为输出和输入维度,选择较小的 Gram 矩阵,并记有效 polar 因子为 。对任意非负整数 ,有
这些恒等式是精确的;实际实现中,用 Polar Express 近似 (Amsel et al., 2026)。
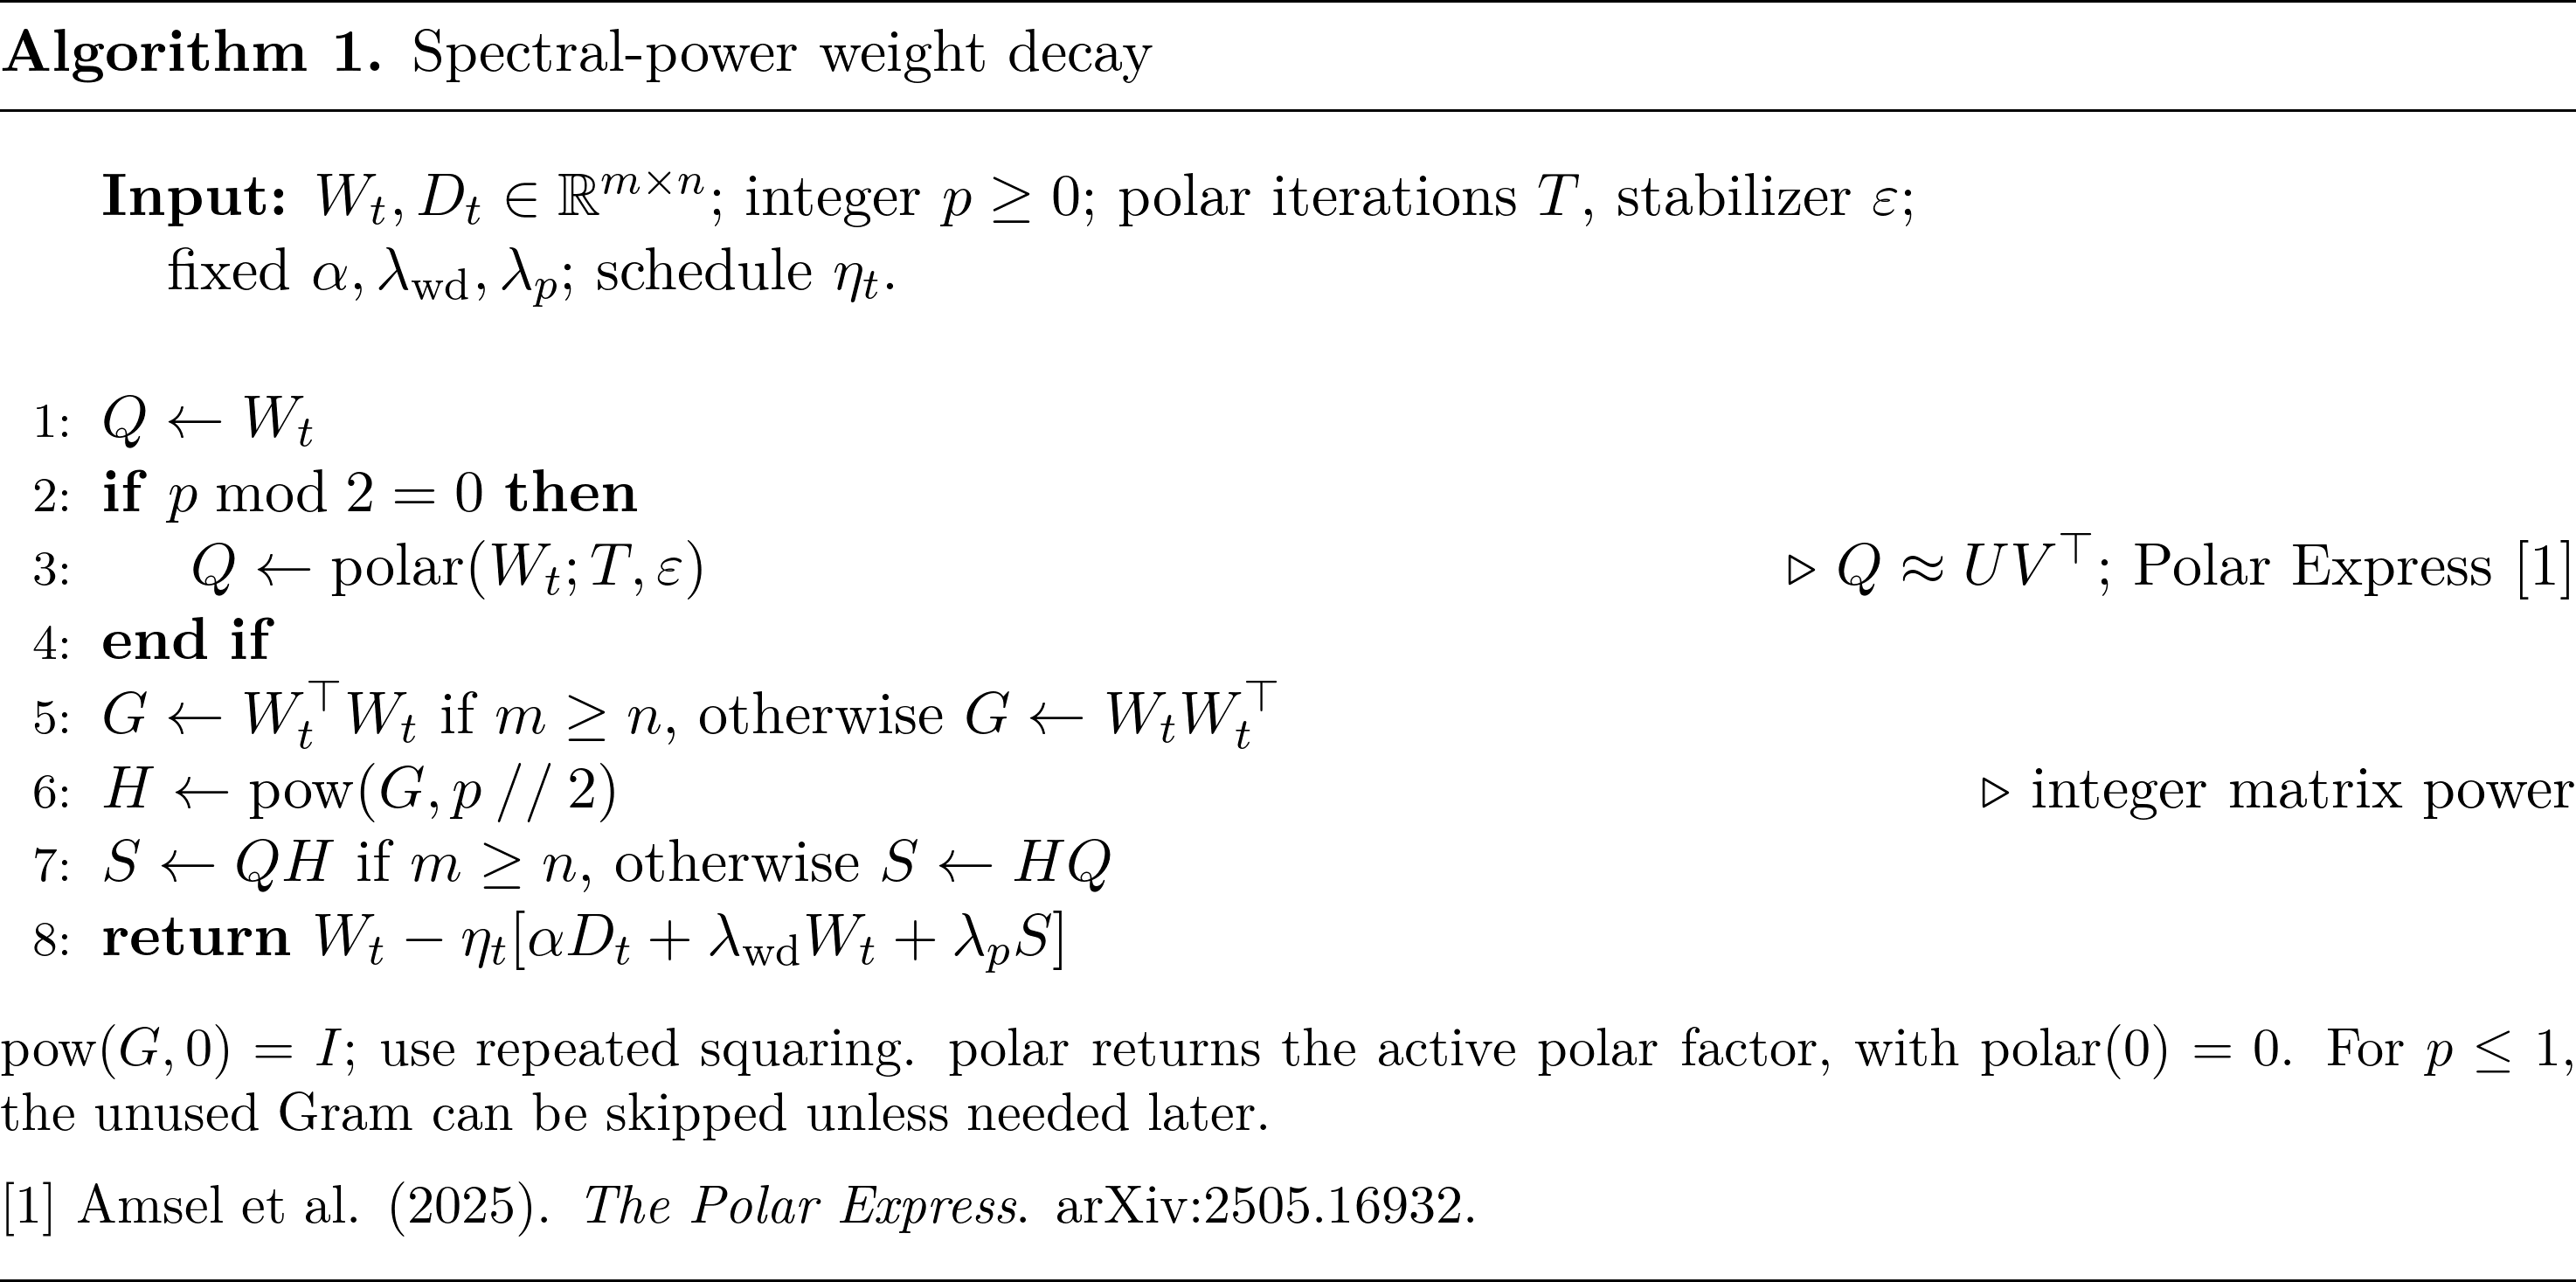
算法 1:通过较小的 Gram 矩阵和 polar 近似计算谱幂权重衰减。奇数幂只需矩阵乘法,偶数幂还需 Polar Express。最后一行允许普通 WD 与谱项叠加使用。
和 都不必构造 Gram 矩阵。更高次幂可通过重复平方复用中间结果,例如 。实际开销取决于矩阵形状、幂次和 polar 迭代数;不做 SVD,并不意味着额外的谱项没有计算成本。下面用八次 Polar Express 迭代,简称 PE8,检查近似精度。
PE8 与 SVD:小矩阵实现检查
我们在满秩 、 和 矩阵上测试 FP32 PE8,奇异值按对数等距分布,随机种子为 42–44。记条件数为 。八组五次多项式系数采用 Polar Express 构造,设计下界为 ,安全缩放为 1.01。参考结果来自同一 FP32 输入的 FP64 SVD。表中每一项是九个形状与种子组合中最大的相对 Frobenius 误差 。
直接返回 。条件数为 时,许多归一化奇异值落在多项式设计区间以下,八次迭代无法在等权的 polar 方向中准确恢复这些模态,因此 的误差很大。它们对 和 的贡献则被 压低。后两列的小误差说明衰减方向在相对 Frobenius 范数下近似准确,并不表示每个奇异模态都得到了准确恢复。
3.3 纯衰减:区分尺度与形状
先只看衰减。 记连续时间 为累计调度时间 ,并令 。由于衰减保持奇异方向,每个正奇异值满足
对初始为正的模态,下文所用幂次的解为
相对收缩速率更直接地揭示了不同幂次的区别:
时,每个模态都损失相同比例的大小。 时,大模态相对收缩得更快,归一化谱因而变平。 时,小模态相对收缩得更快,并可在有限连续时间内到达零。
连续流与有限步更新需要分开看。 的正部解,与核范数近端软阈值具有相同形式 (Cai et al., 2010; Parikh & Boyd, 2014)。但显式 polar 更新如果跨过零点,得到的是 ,而非将模态截为零。因此,对显式算法而言,“抑制谱尾”比“自动截断秩”更准确。
当 时,
只有在 时,相对 Frobenius 收缩速率才与当前谱无关。
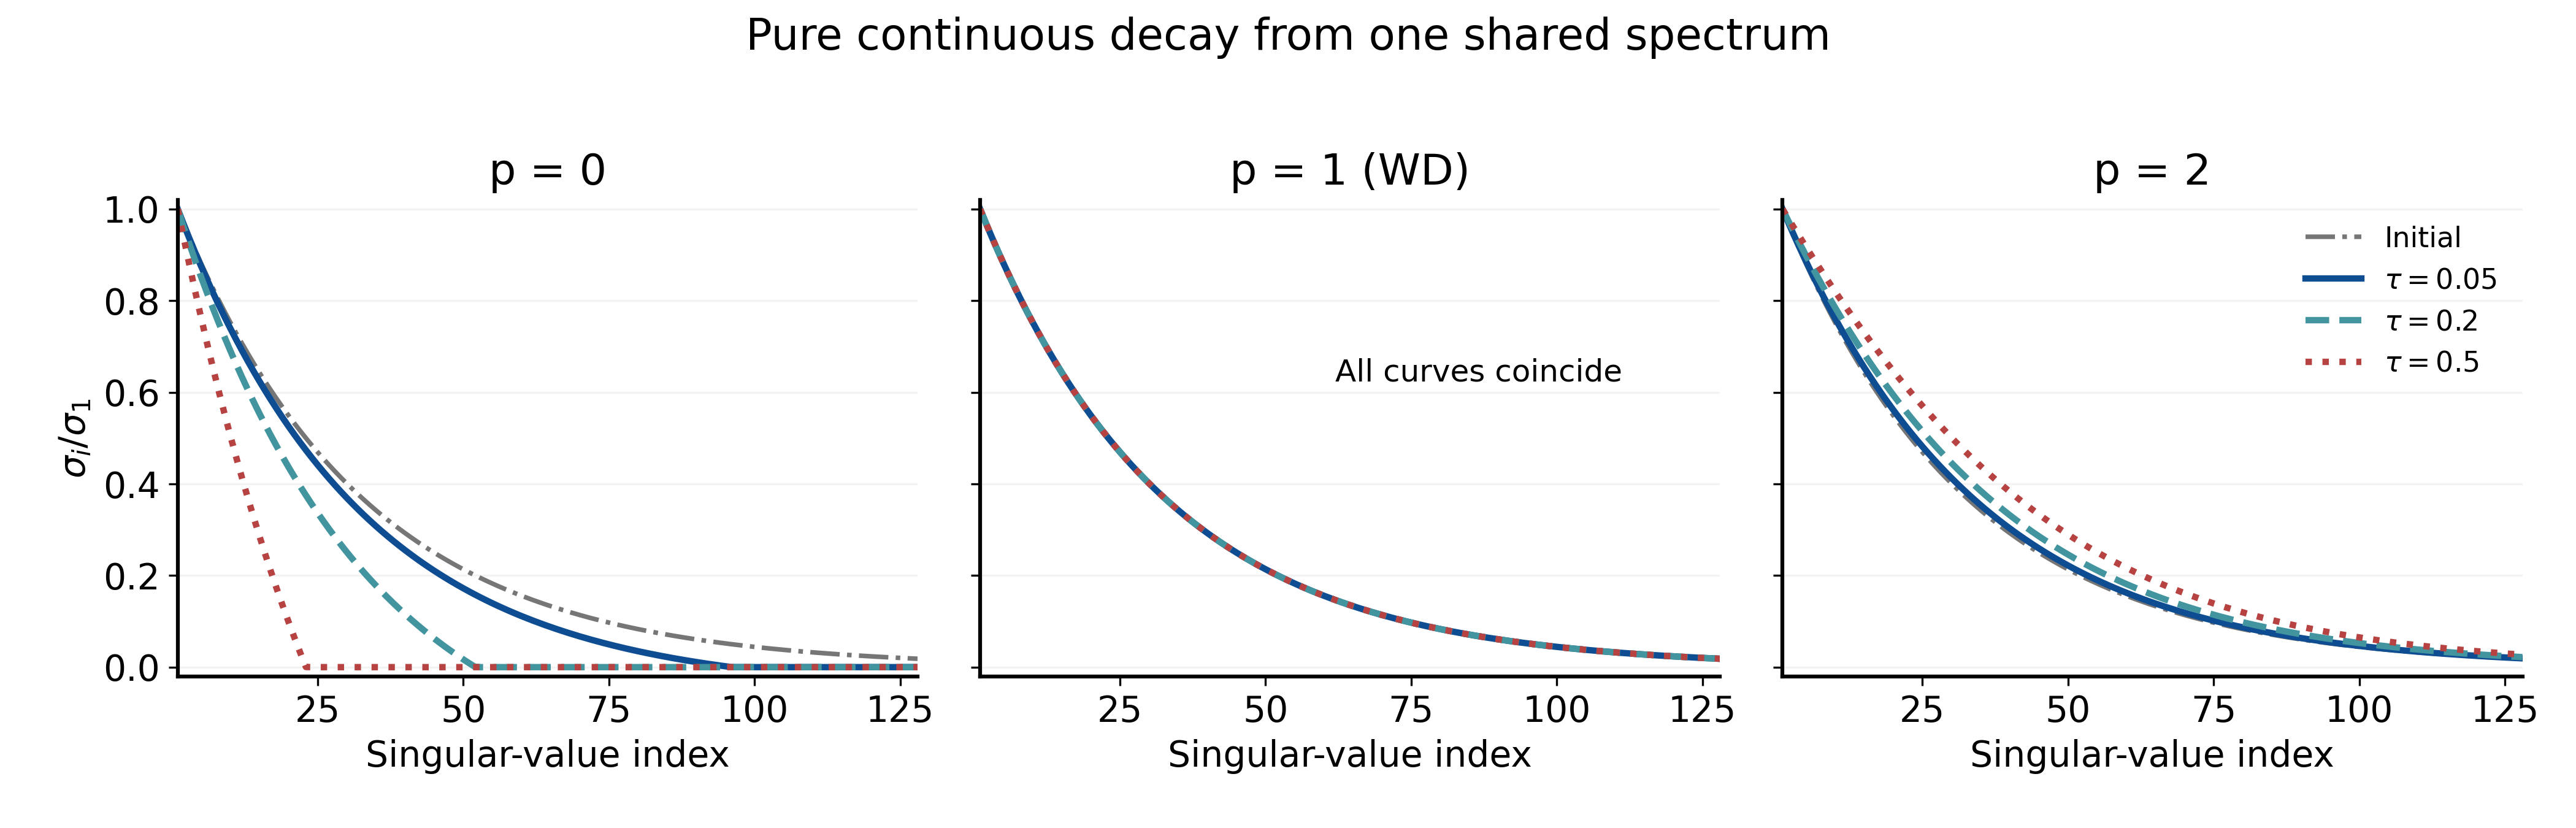
图 1:从同一初始谱出发,在不同累计衰减量 下的纯连续衰减。每条曲线都用当前最大奇异值归一化。 时小模态先到达零; 时归一化曲线完全重合; 时相对谱逐渐变平。
的归一化曲线上移,并不表示某些奇异值在增长。所有有效模态都在缩小,只是最大奇异值缩小的比例更大。后面比较训练所得谱时,同样需要区分这两件事。
当 时,纯衰减也可近似描述一小段训练过程。单凭学习率下降不能判断这一条件成立,因为任务项和衰减项共享同一个乘子 。
系数也能改变形状。 对一步显式更新,令 ,并记 为最大模态受到的相对衰减。若这一步保持符号和顺序,则
对 ,这个导数在 时为零, 时为正, 时为负。幂次决定形状向哪个方向变化,系数决定一步改变多少。普通 WD 是其中的特殊情形:单独调整衰减强度,不会改变归一化谱。
3.4 可解的线性模型:从权重谱到输出谱
加入拟合目标后,我们可以直接求解最终的权重谱。设稠密教师矩阵为 ,奇异值为 。考虑
这里的 是目标函数中的惩罚系数;对普通梯度下降,它对应前面记法中的 。由迹不等式,最优解可以取与教师矩阵对齐的奇异向量 (Lewis, 1995)。平方损失强凸、谱惩罚凸,因此最优矩阵唯一。其奇异值 满足如下标量问题 (Parikh & Boyd, 2014):
时,,所有教师模态按相同比例缩小。 且 时,
大模态因此受到更强的相对压缩。 时,标量方程同样有唯一非负根; 则是奇异值软阈值 (Cai et al., 2010)。这给出了同一个拟合任务在不同正则化下的谱响应。
下面用普通梯度下降验证这些解, 使用近端更新。随后利用白化输入,精确检查学到的权重谱如何出现在输出中。
有限样本验证。 在 维中构造 个成对正负样本,通过约化 QR 分解得到中心化设计矩阵 ,满足
该等式的最大绝对误差为 ,坐标均值的最大绝对值为 。非对角教师矩阵的奇异值为 ,取 。这个构造使有限样本输入在数值精度内精确白化 (Kessy et al., 2018)。
数值优化所得的奇异值 与解析值 高度吻合:
| 解析奇异值 | 协方差–SVD 恒等式误差 | ||
|---|---|---|---|
| 0 | |||
| 1 | |||
| 2 | |||
| 4 |
表中最后一列检查的是另一个恒等式。由于输出矩阵 已中心化,
因此,输出协方差的非零特征值为 ,而 的奇异值为 。在这组输入下,这个恒等式对任意 都成立;它与前一列“优化是否到达解析解”的检查是两回事。
从 的解到 的解,输出能量有效秩由 升至 ,激活 eRank 由 升至 。两者都反映谱集中程度下降,但前者按奇异值平方加权,后者按奇异值加权。
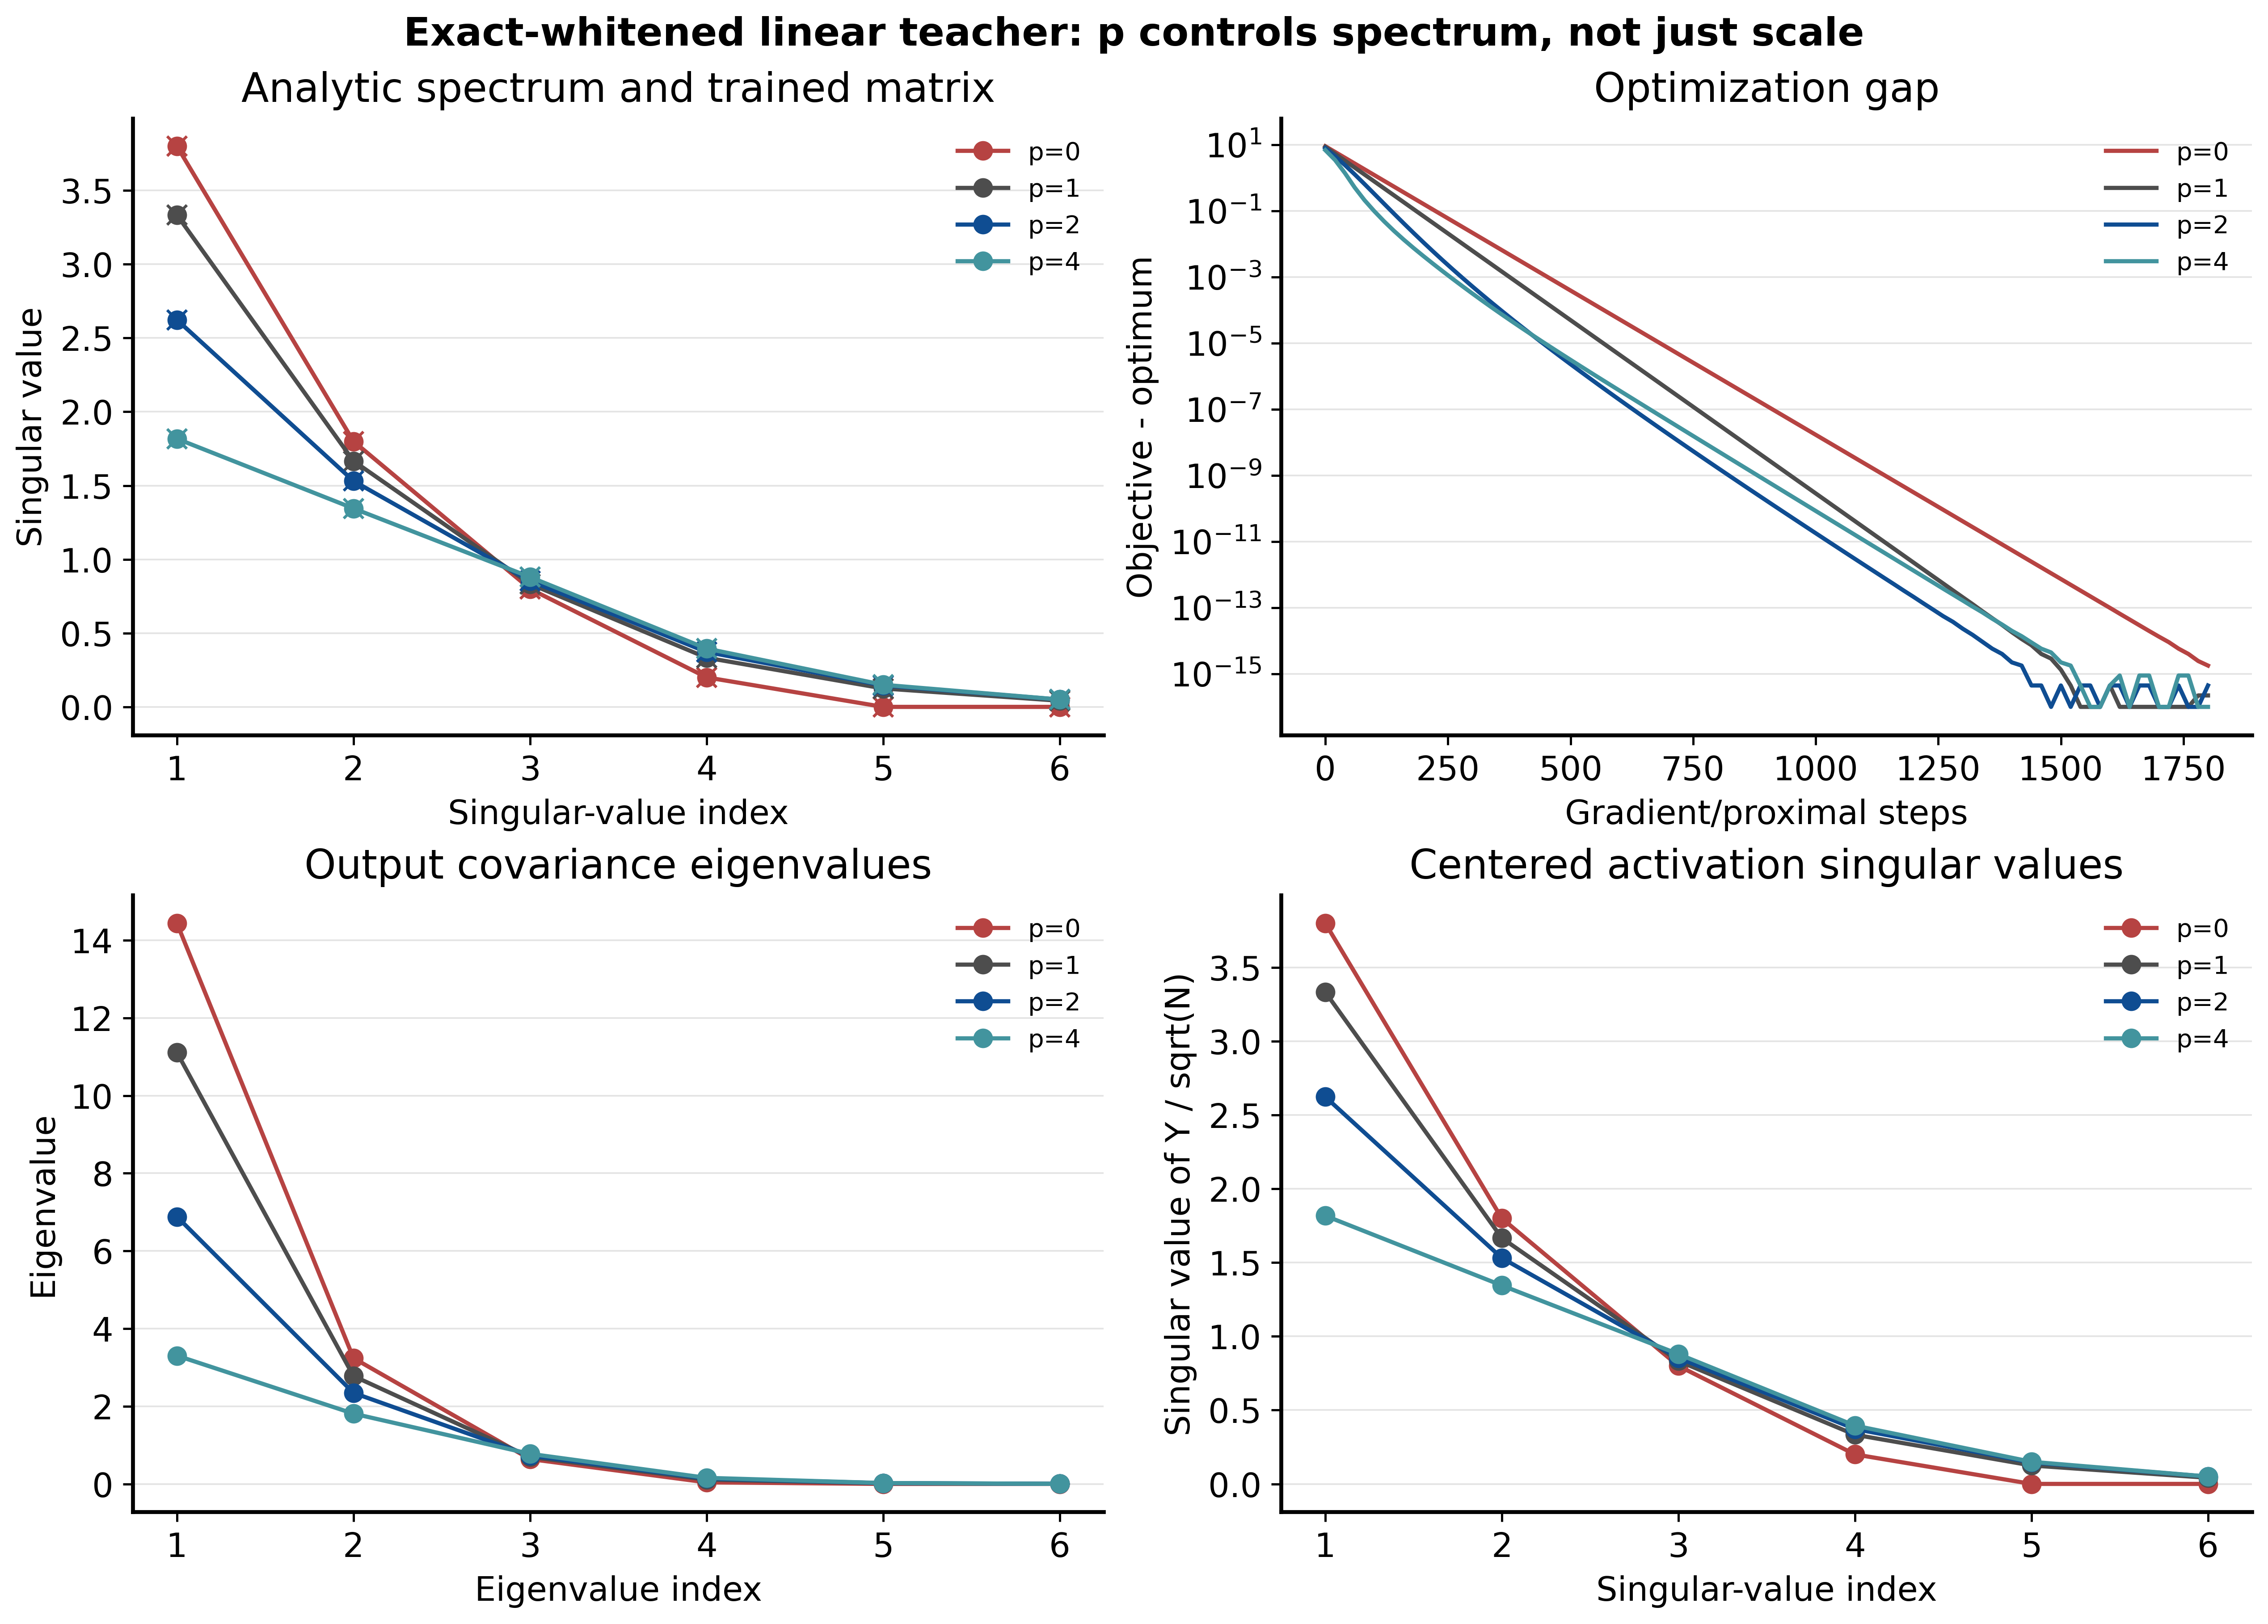
图 2:线性教师实验。左上:解析与优化所得的权重谱;右上:各次运行的正则化目标与其自身最优值之差;左下:输出协方差特征值;右下:中心化输出除以 后的奇异值。
左上和右下两幅图的一致性来自白化条件,并非额外发现的经验相关性。右上图则说明,不同终点谱不能归因于某些运行尚未充分收敛;它比较的并不是所有幂次共享的、未加正则的损失。
一般的中心化输入若具有协方差 ,输出协方差应为 ,不再是 。此时,输入谱及其与权重奇异向量的对齐方式也会影响输出。这正是为什么在 Transformer 中,不能直接用权重谱代替激活谱。
3.5 八层 Transformer:训练后还能看到谱塑形吗?
接下来在 8 层、宽度 512 的 SwiGLU Transformer 上比较 。先固定衰减系数,再分别扫描每个幂次的系数。
改变幂次。 最大模态之外的谱会怎样变化?
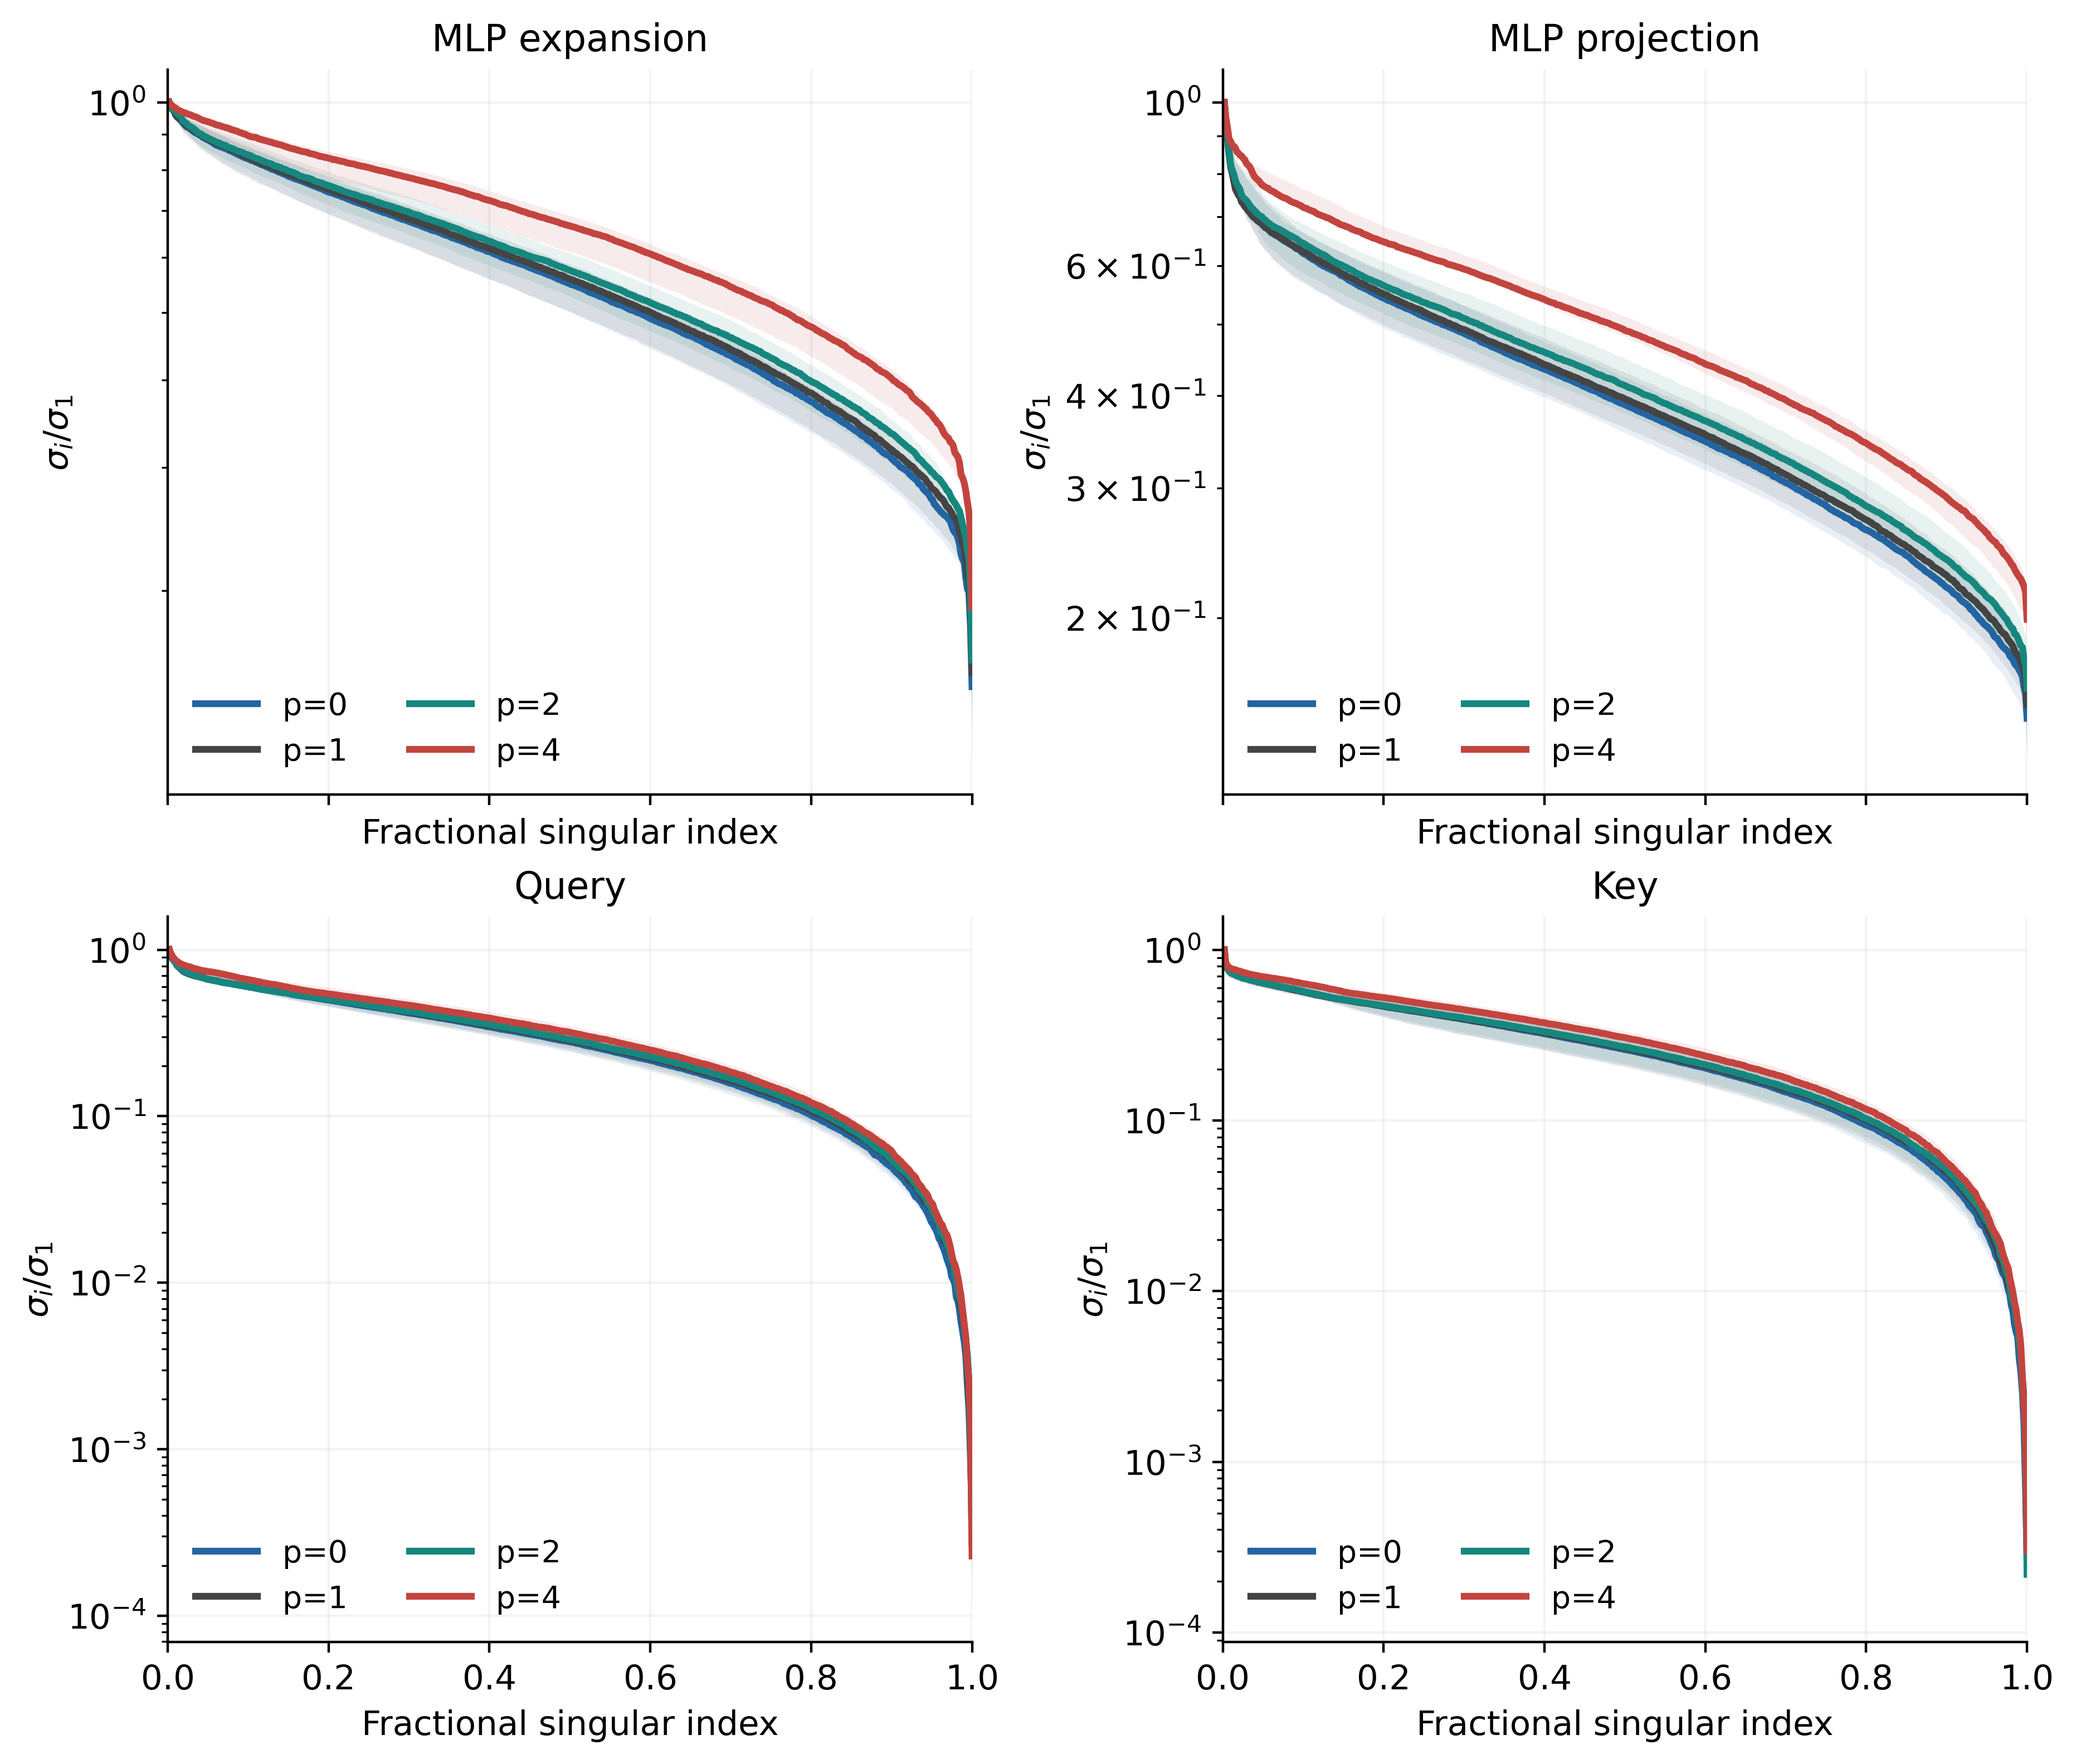
图 3:八层 Transformer 的归一化权重谱。曲线为各层中位数,阴影为层间第 25–75 百分位区间。横轴为归一化奇异值序号,纵轴为 。
的区别最明显,尤其是在 MLP 扩张和投影矩阵上:更多模态相对于最大模态保持了较大的幅度。Q、K 的差别则小得多,曲线大体重叠。纯衰减分析中的趋势在训练后仍然可见,但不同矩阵类型的变化幅度很不一样。
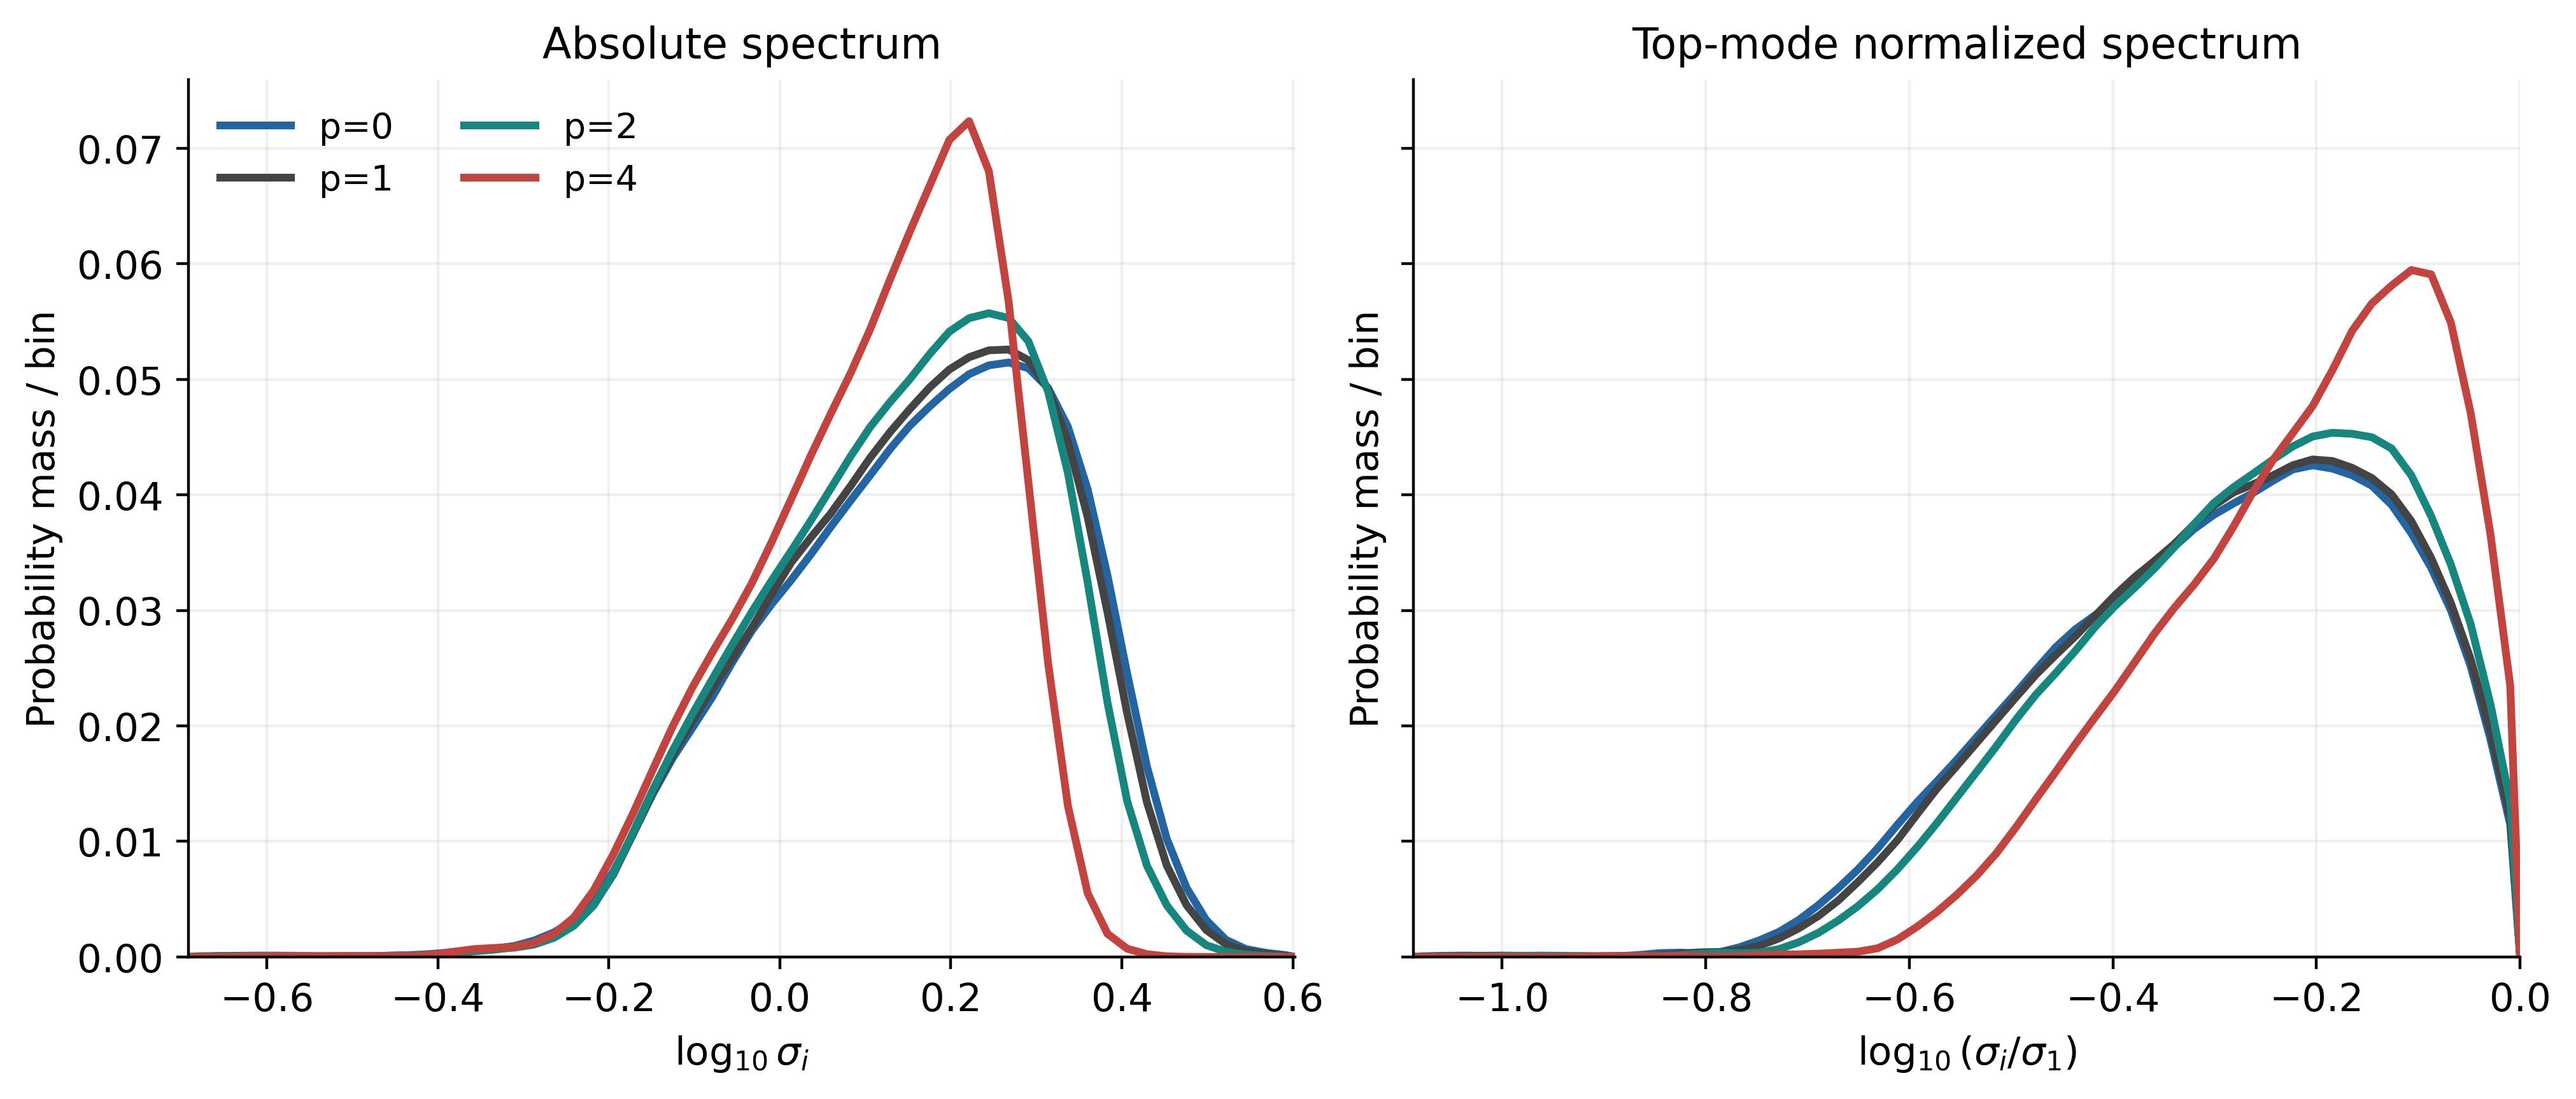
图 4:八个 MLP 扩张矩阵的谱分布。左图为 ,右图为 ,其中 取各矩阵自身的最大奇异值。每个矩阵贡献相同概率质量;纵轴为每个分箱的概率质量,平滑仅用于显示。
两幅图将绝对大小与相对集中程度分开了。 下,绝对谱的上端向左收缩,归一化谱的主体却向零靠近,也就是向 靠近。因此,归一化谱变平可以来自谱头受到更强压缩,并不要求其余奇异值的绝对大小增加。分布峰值变高,表示同样的概率质量集中到了更窄的对数奇异值区间,而不是矩阵多出了模态。
固定系数 时,终点统计为:
| MLP 稳定秩 | QK 稳定秩 | 归一化注意力熵 | |
|---|---|---|---|
| 0 | 171.0 | 24.29 | 0.5771 |
| 1 | 173.8 | 24.51 | 0.5758 |
| 2 | 183.5 | 25.03 | 0.5823 |
| 4 | 226.6 | 26.72 | 0.5982 |
MLP 稳定秩变化最大,QK 乘积的稳定秩也有所上升。注意力熵却没有随幂次单调变化:从 到 略降,之后才上升。权重谱的集中程度,不能直接决定 softmax 后的注意力分布。
改变系数。 为了区分衰减的直接作用与训练中的交互,先对同一检查点的谱施加解析纯衰减:
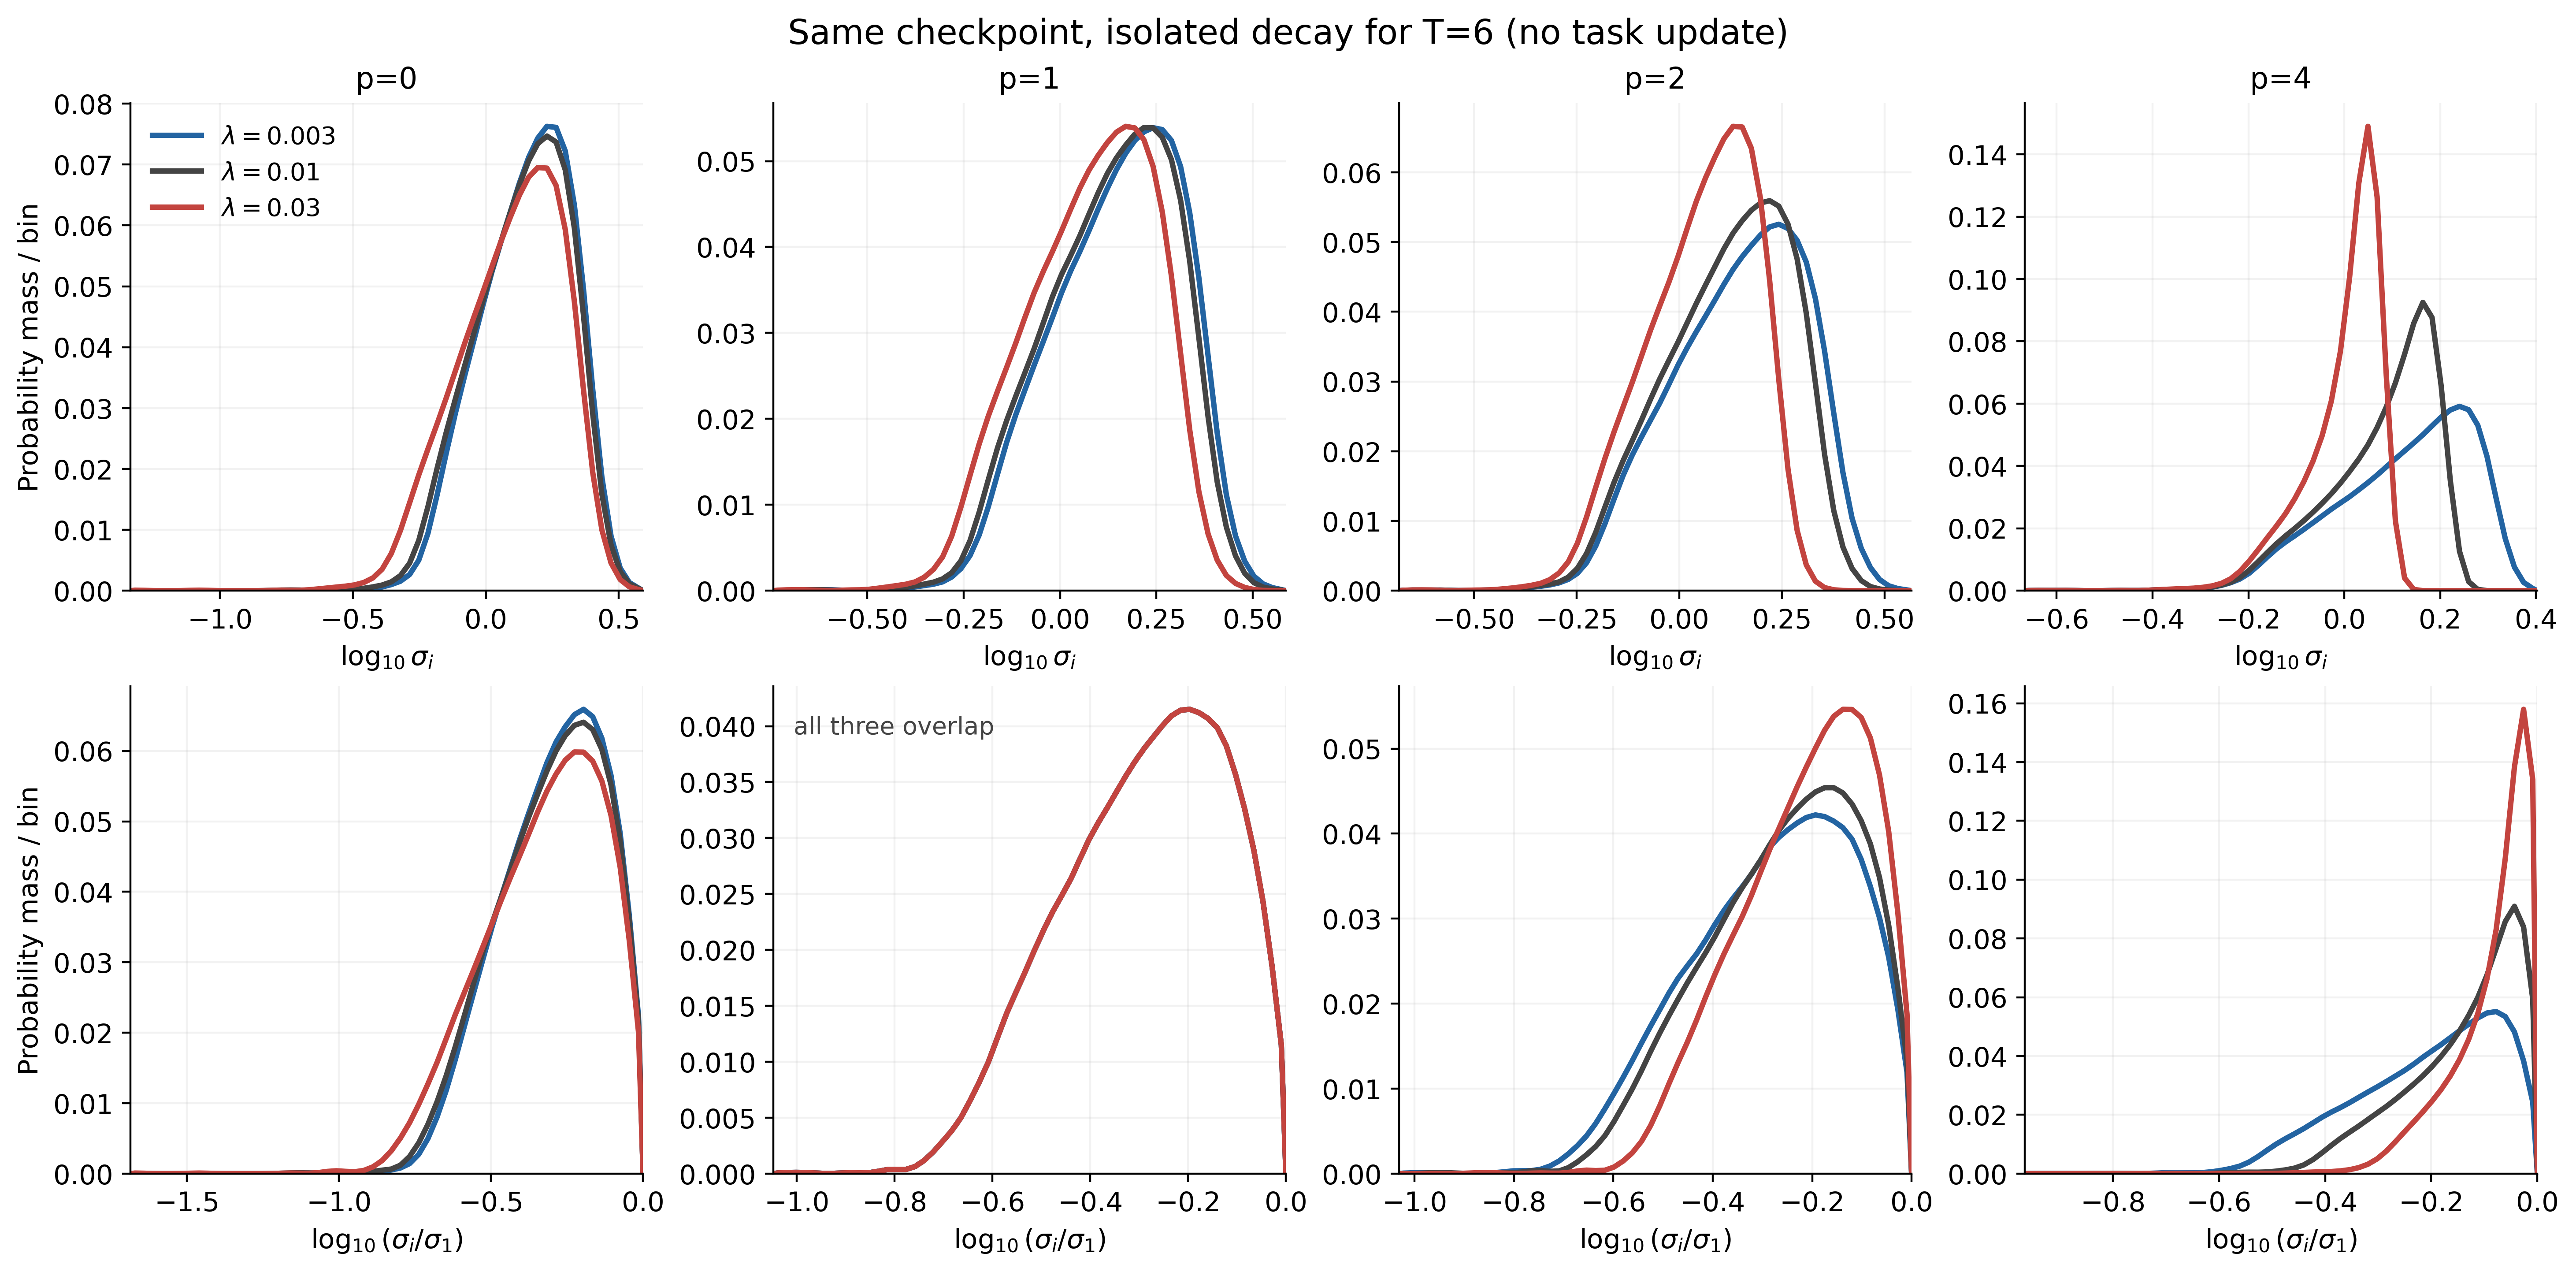
图 5:从同一检查点出发,在图中标注的固定时长 内做解析衰减,不包含任务更新。四列依次为 ,上下两排分别为绝对对数谱和最大模态归一化后的对数谱。这里的 是衰减时间,不是算法 1 中的 polar 迭代数。
时,增大系数只会平移绝对对数谱,归一化分布完全不变。 时,谱头与主体之间的相对间距还会缩小,在 下尤其明显。归一化分布变窄、峰值变高,是奇异值谱变平的另一种表现。 则相反,主要抑制相对谱尾。
完整训练后,将系数从 增至 ,MLP 扩张矩阵出现了以下变化:
| 归一化对数谱距离 | 平均稳定秩变化 | |
|---|---|---|
| 0 | 0.01955 | −5.6% |
| 1 | 0.00220 | −0.6% |
| 2 | 0.03131 | +11.4% |
| 4 | 0.06536 | +25.0% |
谱距离如何计算
令 为第 层 MLP 扩张矩阵的第 个奇异值除以该矩阵的最大奇异值。对八层、每层 512 个模态,定义
奇异值已经排序且等权,因此该指标等于每层两个对数谱分布的一阶 Wasserstein 距离,再对层取平均。它不依赖直方图分箱或显示平滑。距离反映形状变化的大小,稳定秩和谱曲线则帮助判断变化方向。
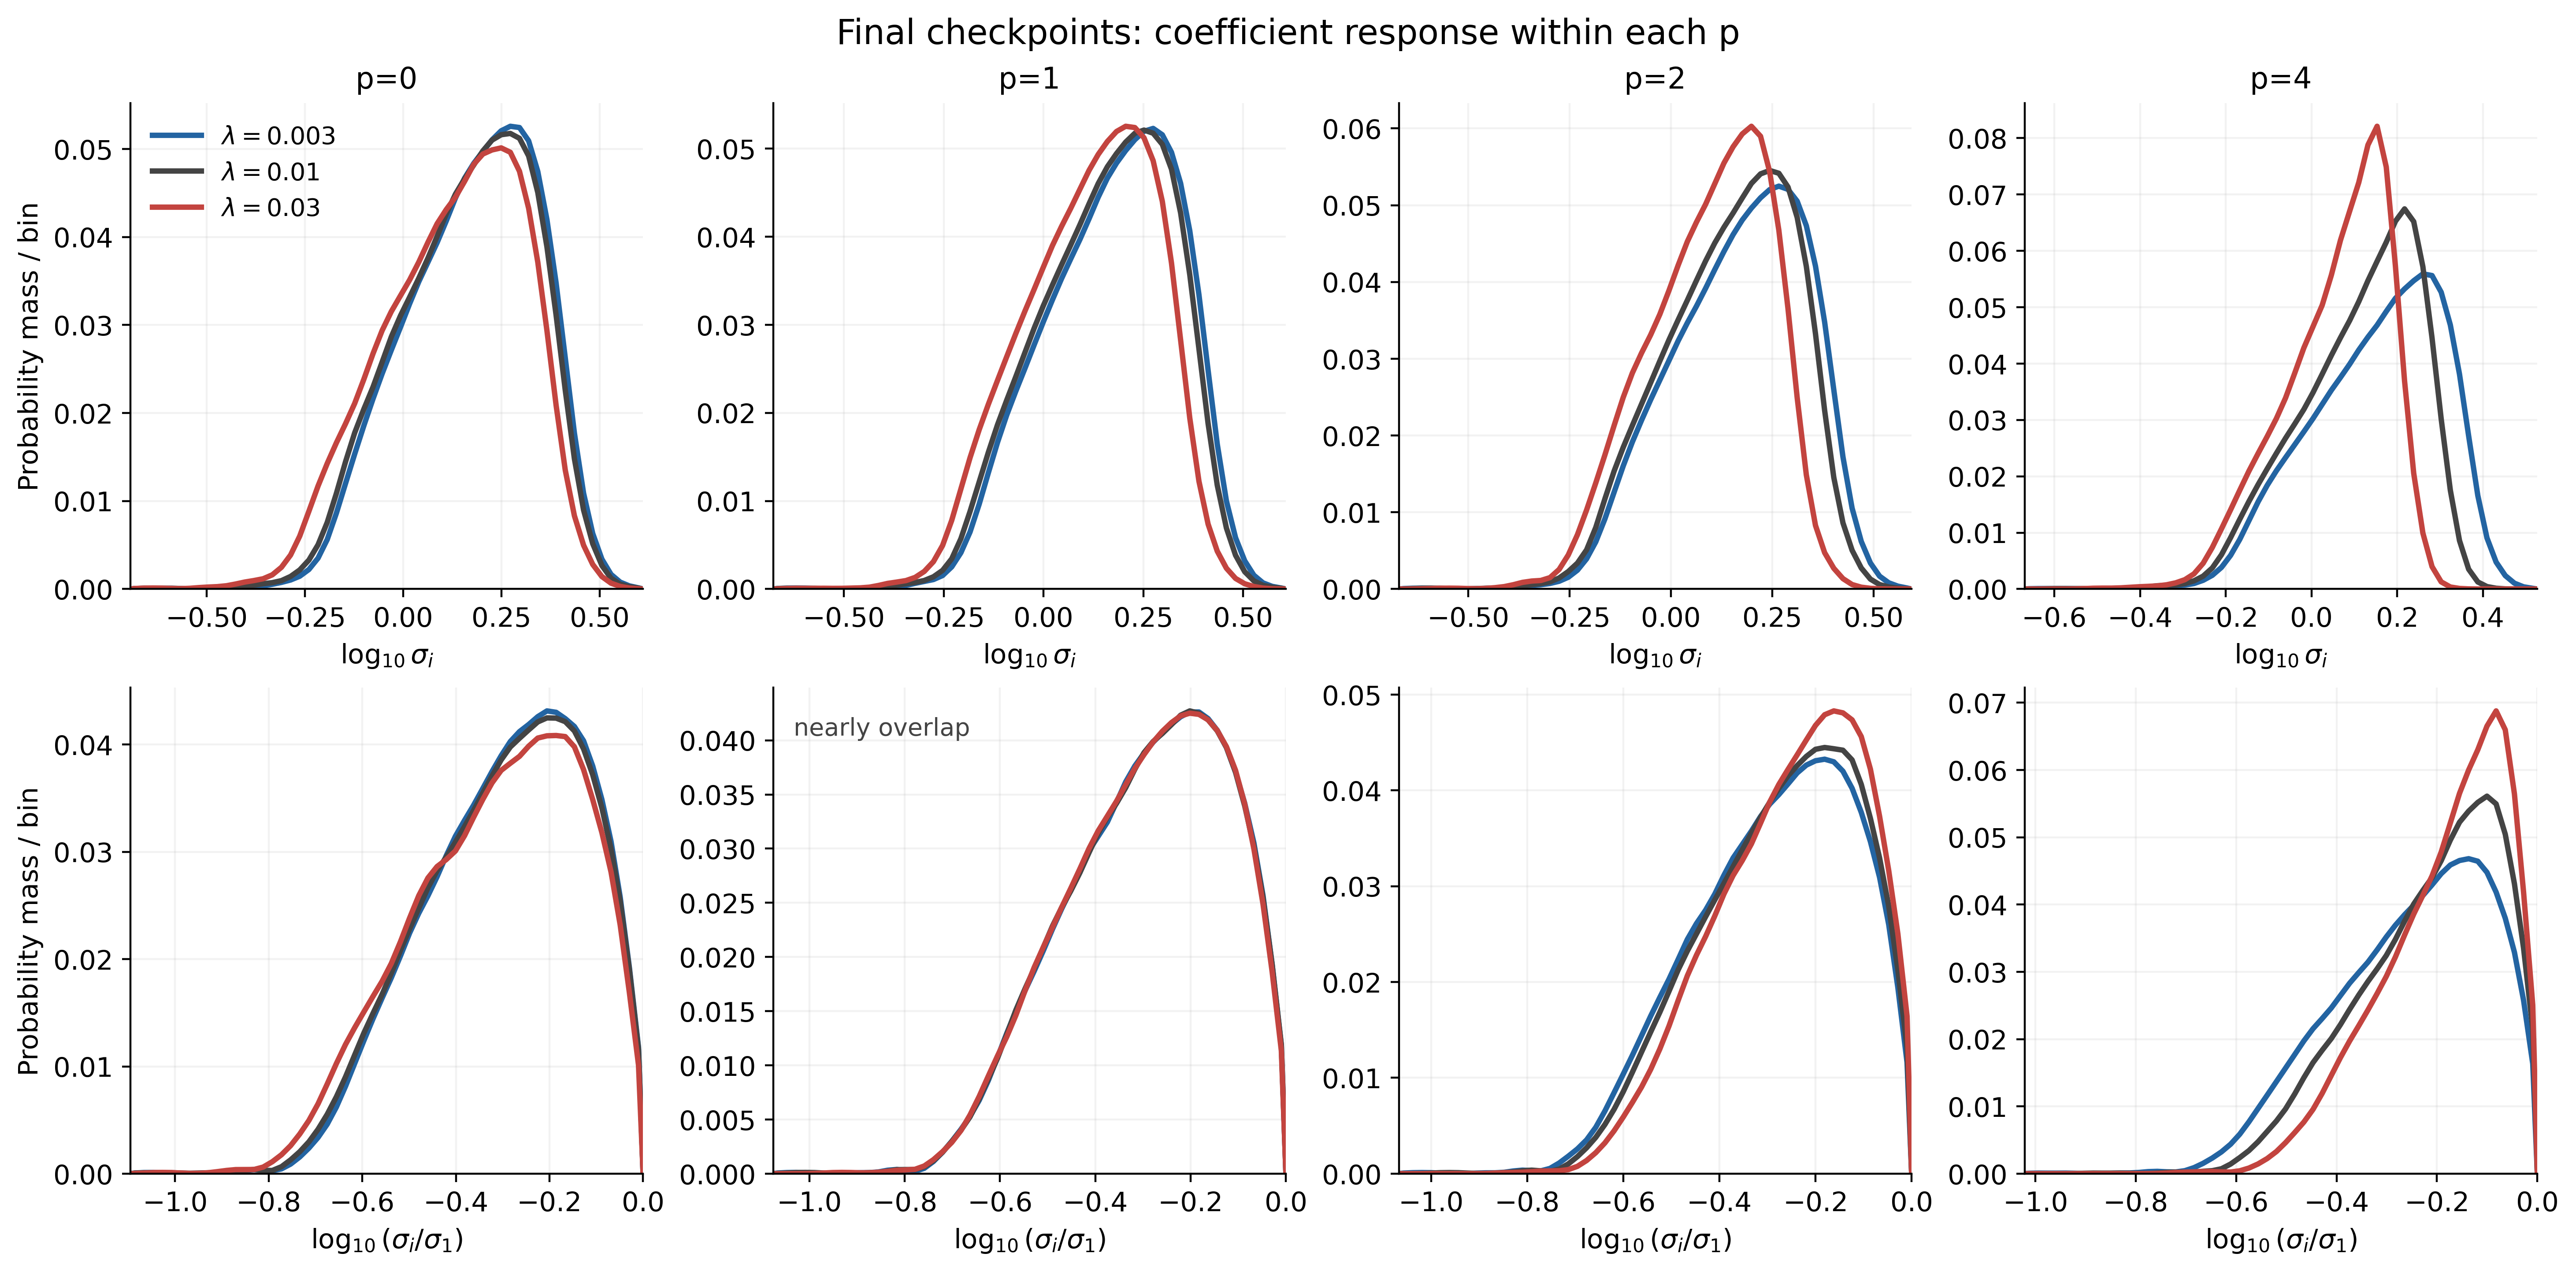
图 6:完整训练结束时的 MLP 扩张谱,使用与图 5 相同的系数。不同于纯衰减对照,这些检查点经历了各自的任务更新与衰减轨迹。 的归一化曲线近似重合,其他幂次的形状变化更大。
训练所得的 MLP 谱保留了纯衰减对照中的主要趋势,但不再具有严格的不变性。普通 WD 在这里仅带来较小的归一化形状变化,却不能据此推及所有矩阵:同一扫描中,普通 WD 下 Q、K 的平均稳定秩分别下降了约 7.7% 和 14.4%。一旦加入任务更新,普通 WD 也可能改变最终学到的谱形状。
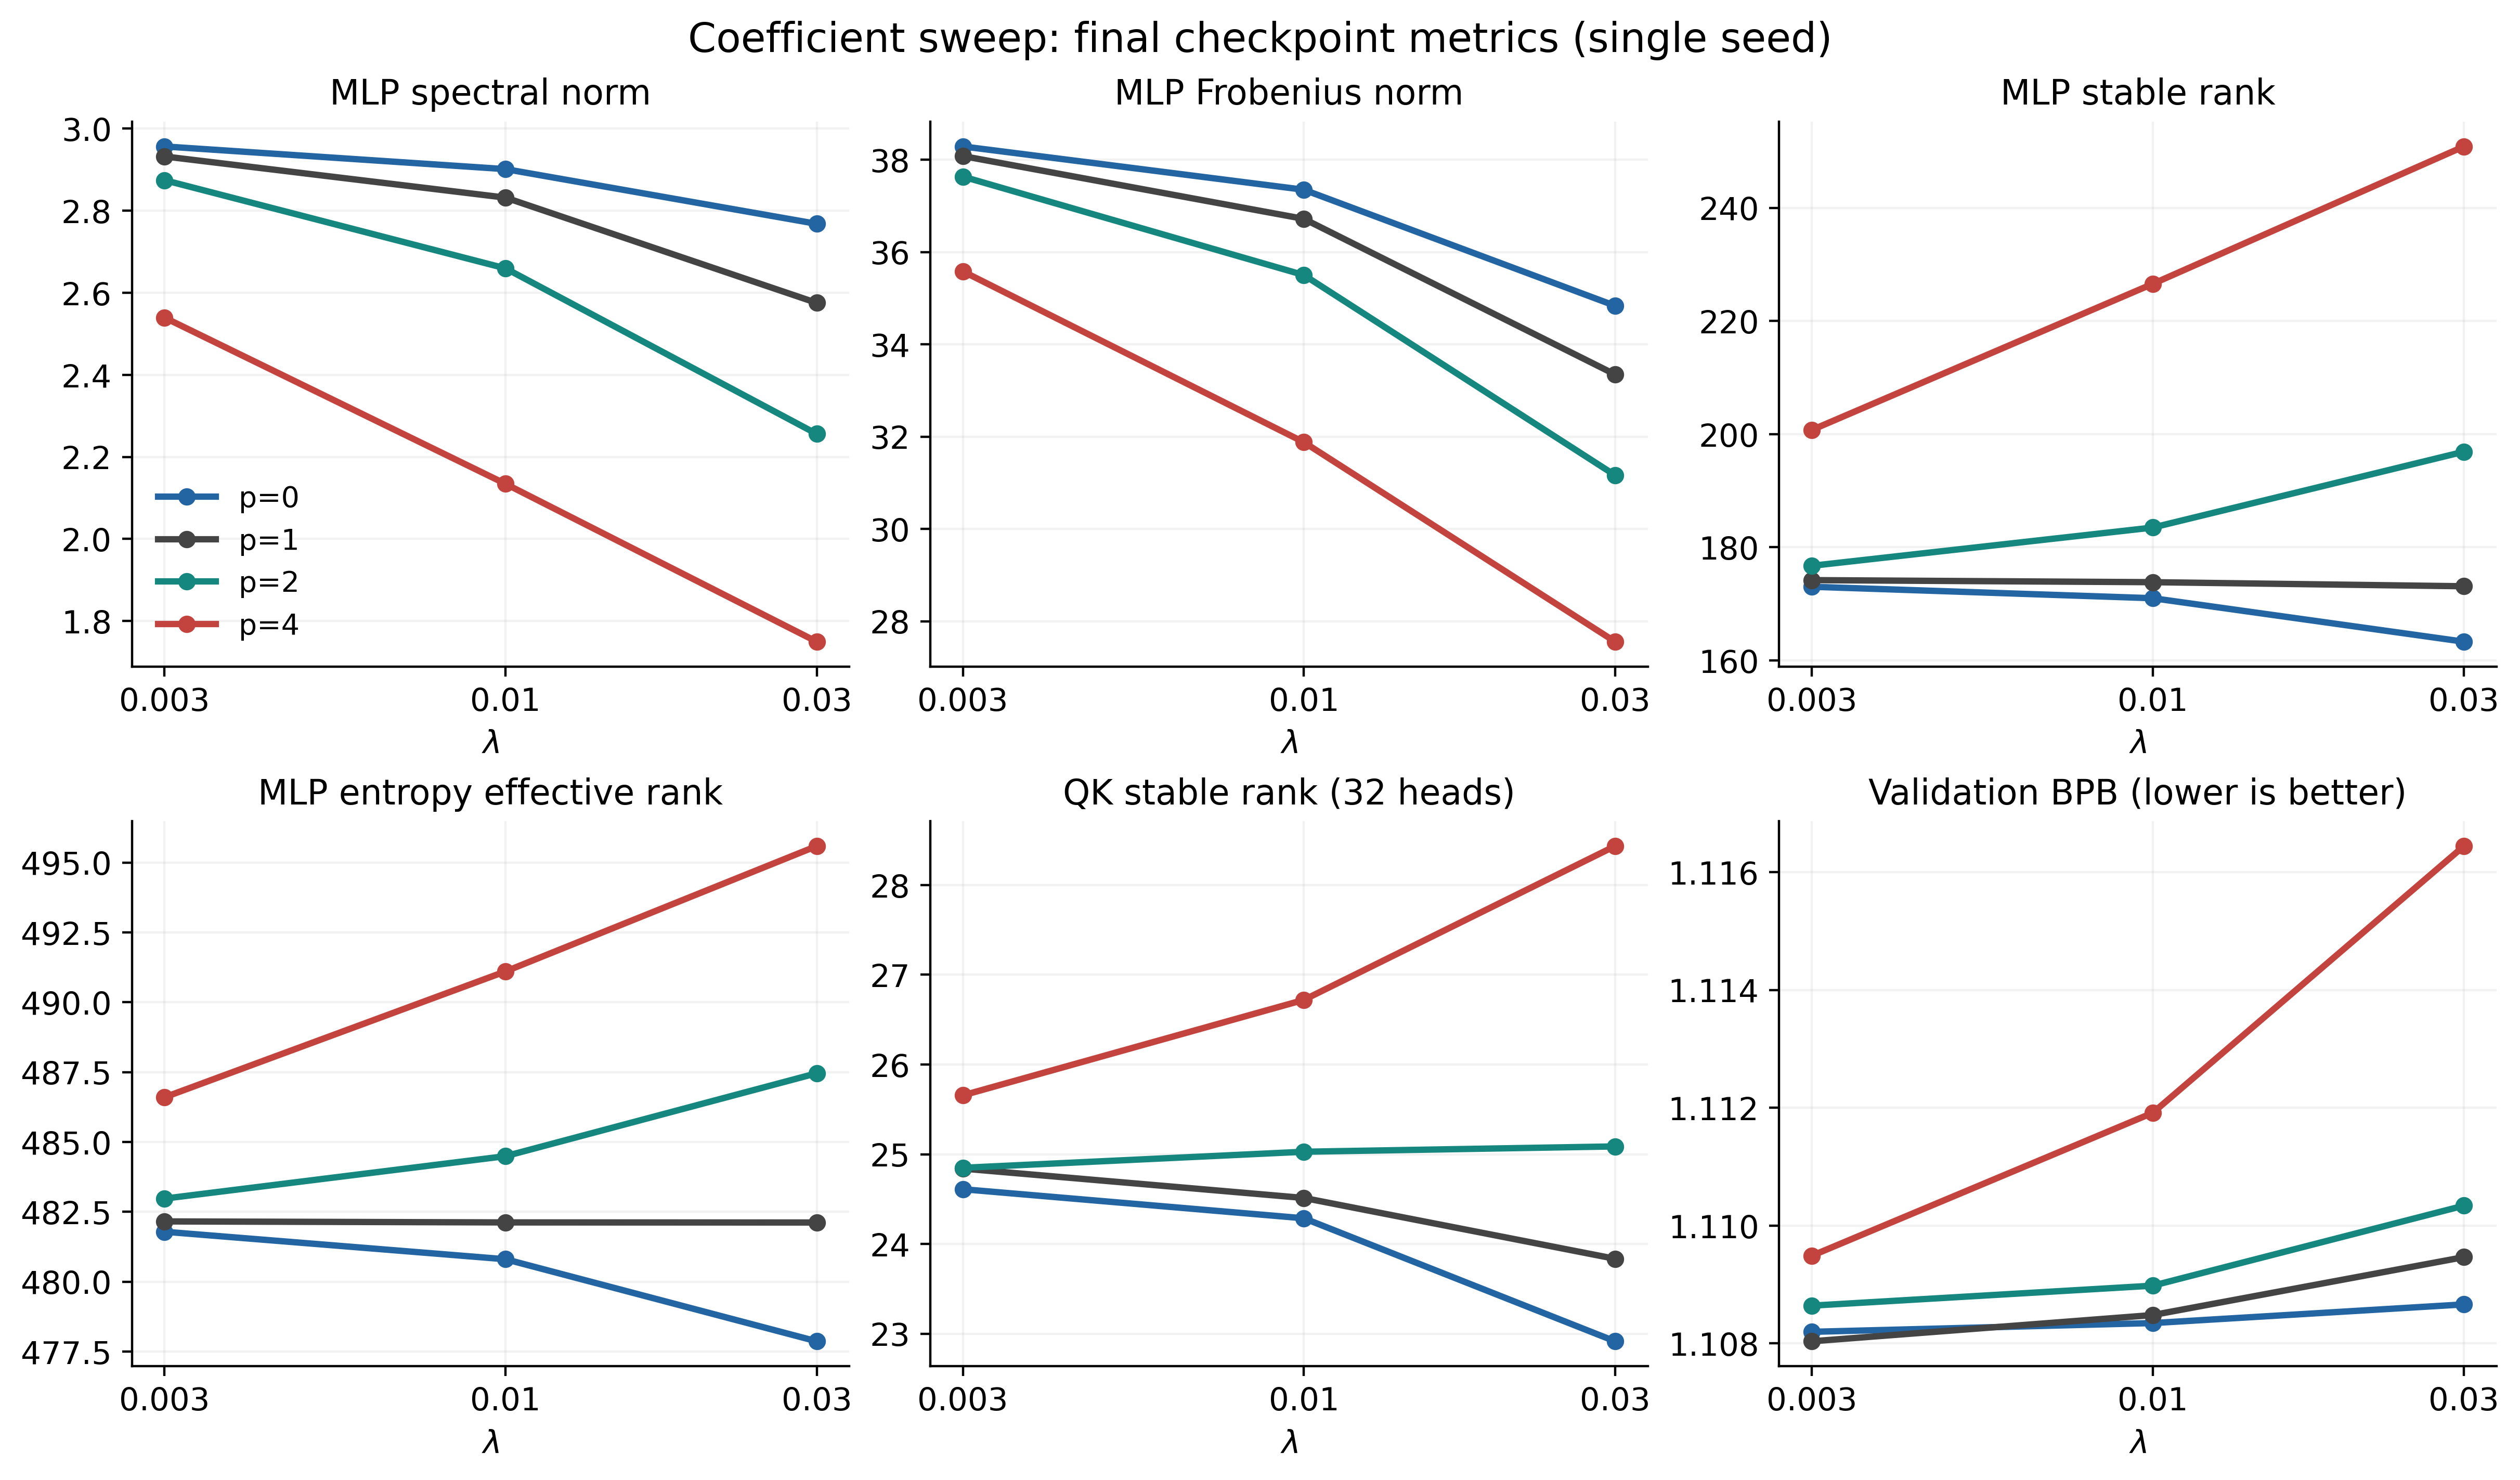
图 7:系数扫描的终点指标。上排依次为 MLP 谱范数、Frobenius 范数和稳定秩;下排依次为 MLP 熵有效秩、32 个 head 的 QK 乘积稳定秩,以及验证集 bits per byte(BPB,越低越好)。
时,系数从 增至 ,MLP 平均稳定秩由约 升至 ,谱范数却由约 降至 ,Frobenius 范数也在下降。这并不矛盾:稳定秩为 ,只要最大奇异值的相对降幅大于 Frobenius 范数的相对降幅,稳定秩就可以上升。相比之下,熵有效秩的变化小得多,更像是已有模态之间的相对大小重新分配,而非出现了大量新的有效维度。
右下角的验证结果同样重要。更强的 衰减给出了这组扫描中更高的秩,却也带来了更差的 BPB。实验说明我们能够调节谱几何,但不支持把秩越大当作越好的训练目标。跨幂次比较时,还应记住:相同的原始系数并没有匹配衰减强度。
接下来要看的是,怎样在具体训练配方中使用这种调节。下面的例子将任务更新的几何与权重衰减的几何分开考察。
4. 案例一:Head-wise Muon 与 V 谱正则化
4.1 从逐 head 更新到完整 V 矩阵更新
GLM-5、Kimi K3 与 Qwen3.8-Next 的公开报告使用 head-wise Muon 更新 query、key、value 权重 (GLM-5 Team, 2026; Kimi Team, 2026; Qiu et al., 2026);DeepSeek-V4.1-Flash 则只对 query、key 使用逐 head 更新 (DeepSeek-AI, 2026)。
用 H 表示逐 head 更新,F 表示完整矩阵更新,字母顺序为 Q/K/V。HHH 对三个投影都按 head 切分;HHF 只改变 V,将 Muon 应用于跨所有 head 的完整矩阵。Muon 正交化的是任务动量,因此这种分组改变了任务更新的几何,并不会直接让权重或激活变得正交。
Q/K 决定信息从哪里被读取,V 则提供被读取和聚合的内容 (Vaswani et al., 2017)。因此,V 的不同 head 能否学到互补的内容特征,值得单独考虑。逐 head polar 分别整形各块动量,完整矩阵 polar 则联合处理整个 V 动量,包括跨 head 的方向重叠。这给 HHF 一个自然的解释:联合更新可能让不同 head 更充分地利用已有表示空间;改变的是学到的表示,网络结构和参数量保持相同。
我们先比较 HHH 与 HHF,再保持 HHF 的更新规则,在 V 上加入谱衰减,观察单独调整权重谱是否有帮助。
4.2 保持更新规则,调整 V 的衰减
在保留普通 WD 的同时,对完整 V 权重加入 项:
实现中使用与学习率相乘的系数: 和 都乘以当前学习率 ,即 LR-coupled 约定。上面的 将它们换成本文的记法。理想衰减方向是 的梯度。在单独且不跨零的衰减步中,第 个模态的相对收缩为
普通项让每个模态按相同比例缩小, 项再按照奇异值大小增加收缩。这样调整的是正则化,Muon 的更新规则保持不变。
额外谱项由更新前的权重计算,形式为 ,polar 因子用 Polar Express 近似 (Amsel et al., 2026)。HHH → HHF → HHF + 比较的是三种分别训练的配方,不是一次训练中的三个阶段。“更新规则不变”也不意味着实际任务更新始终相同;随着参数轨迹分开,梯度和优化器状态也会改变。
训练协议与系数扫描
HHH、HHF 与选定的 运行共享实现、初始化和有序数据流。模型为 12 层、宽度 768,每个 head 的维度为 128。序列长度为 4096,全局 batch 为 524,288 tokens,随机种子为 42。共训练 16,204 步,即 8,495,562,752 tokens。峰值学习率为 0.005,先预热 256 步,再按余弦调度降至峰值的 0.1 倍;普通 WD 系数为 0.1。验证使用 10,485,760 tokens,共评估 164 次。Muon 的缩放为 (Liu et al., 2025),维度取原始完整投影的输入与输出维度。
HHF 的附加 系数从 扫描到 ,在 附近加密。 对照包含 以及 – 的细扫描。 时,附加项就是普通 WD,使 V 的总系数变为 。不同幂次的系数没有按衰减强度匹配。
4.3 验证损失的改善与秩有什么关系
最终验证 NLL 分别为:HHH 的 、HHF 的 ,以及选定 HHF + 的 。从 HHH 到 HHF,改变的是 V 的任务更新范围;再加入 衰减,则在 时,相对 HHF 对照改善了约 。
两条 HHF 轨迹的 V 权重整体 RMS 很接近,附加谱步也远小于任务步。这里并不是衰减主导的训练,而是一个较弱的正则项持续参与更新。纯衰减分析说明这个额外项偏向怎样的谱形状,损失上的效果则来自它与任务更新的交互。
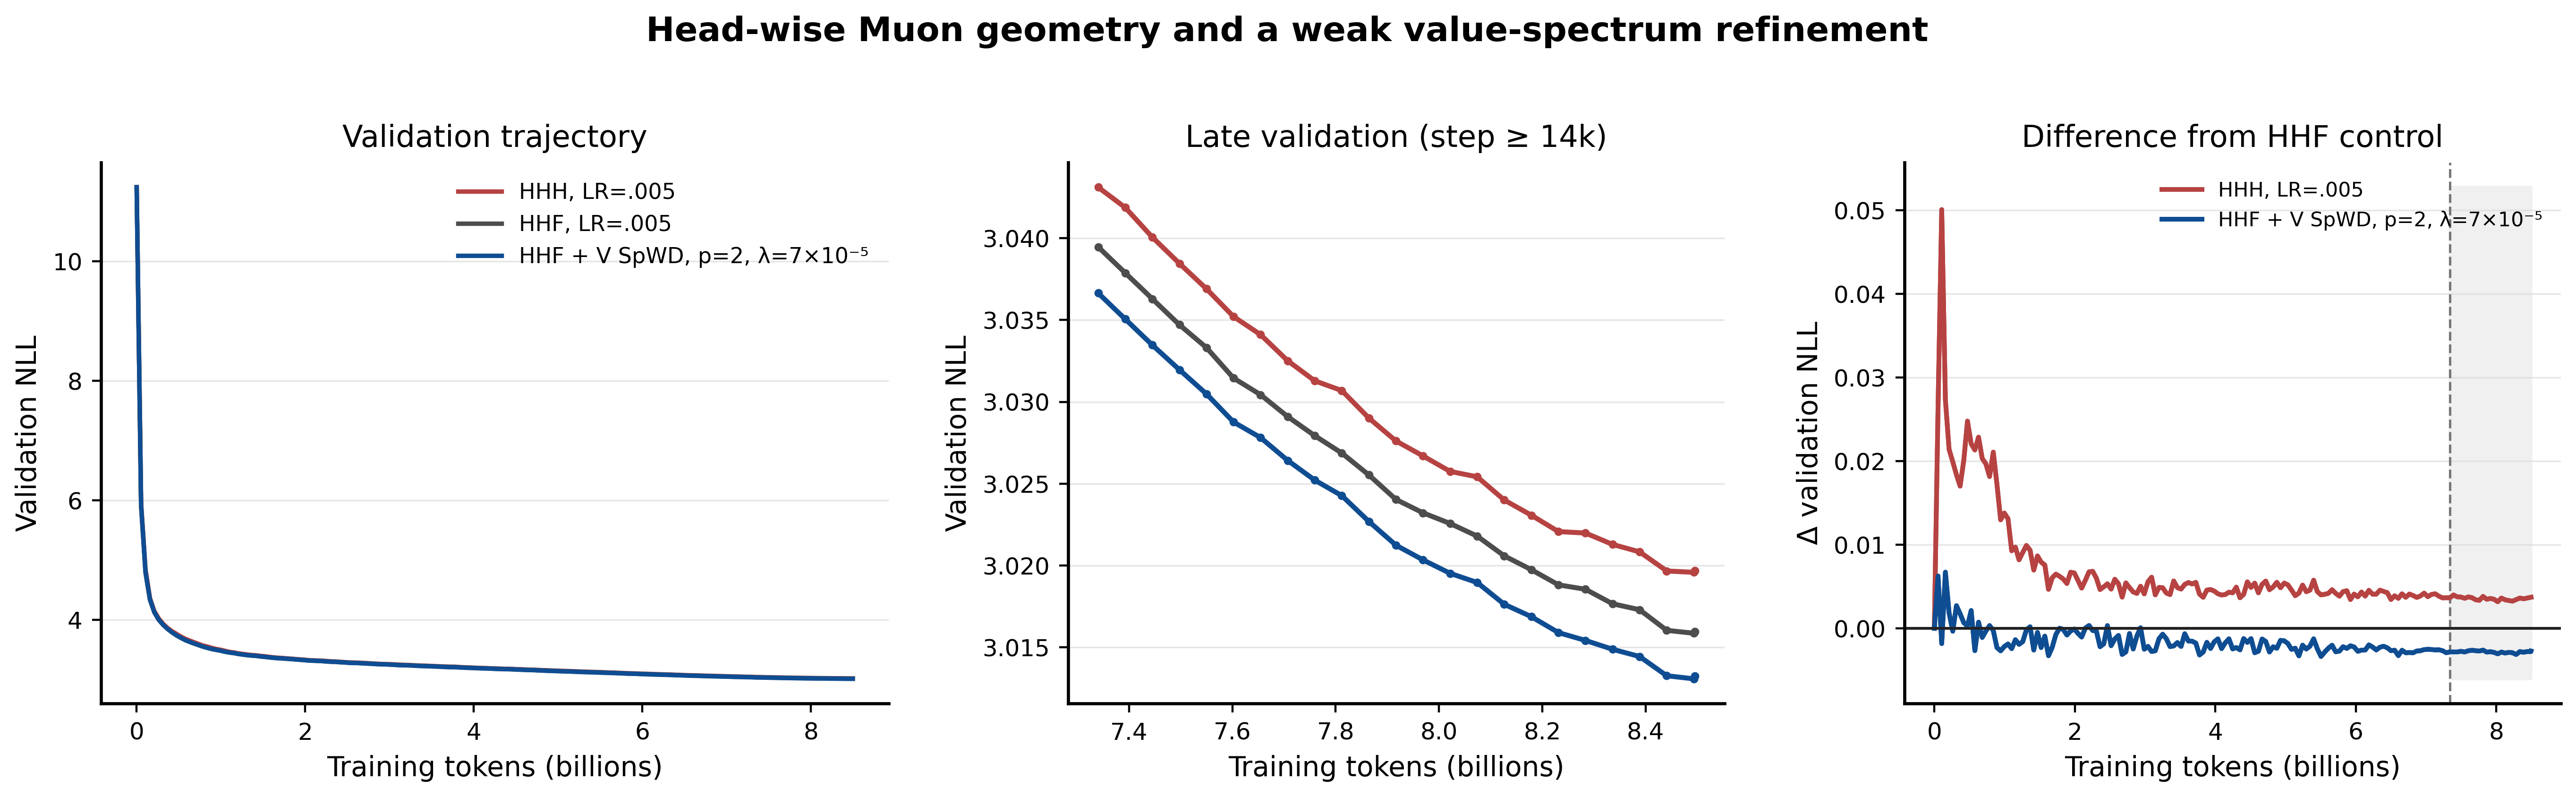
图 8:共同初始化下的 HHH、HHF 和选定 HHF + full-V 运行。左图为完整验证轨迹;中图放大第 14k 步之后的训练;右图为相对 HHF 对照的验证 NLL 差值,阴影标出同一末段窗口。
完整曲线看起来几乎重合,差值图则呈现出整个末段窗口中的持续差异:HHF 的验证损失低于 HHH,加入 衰减后又进一步改善。
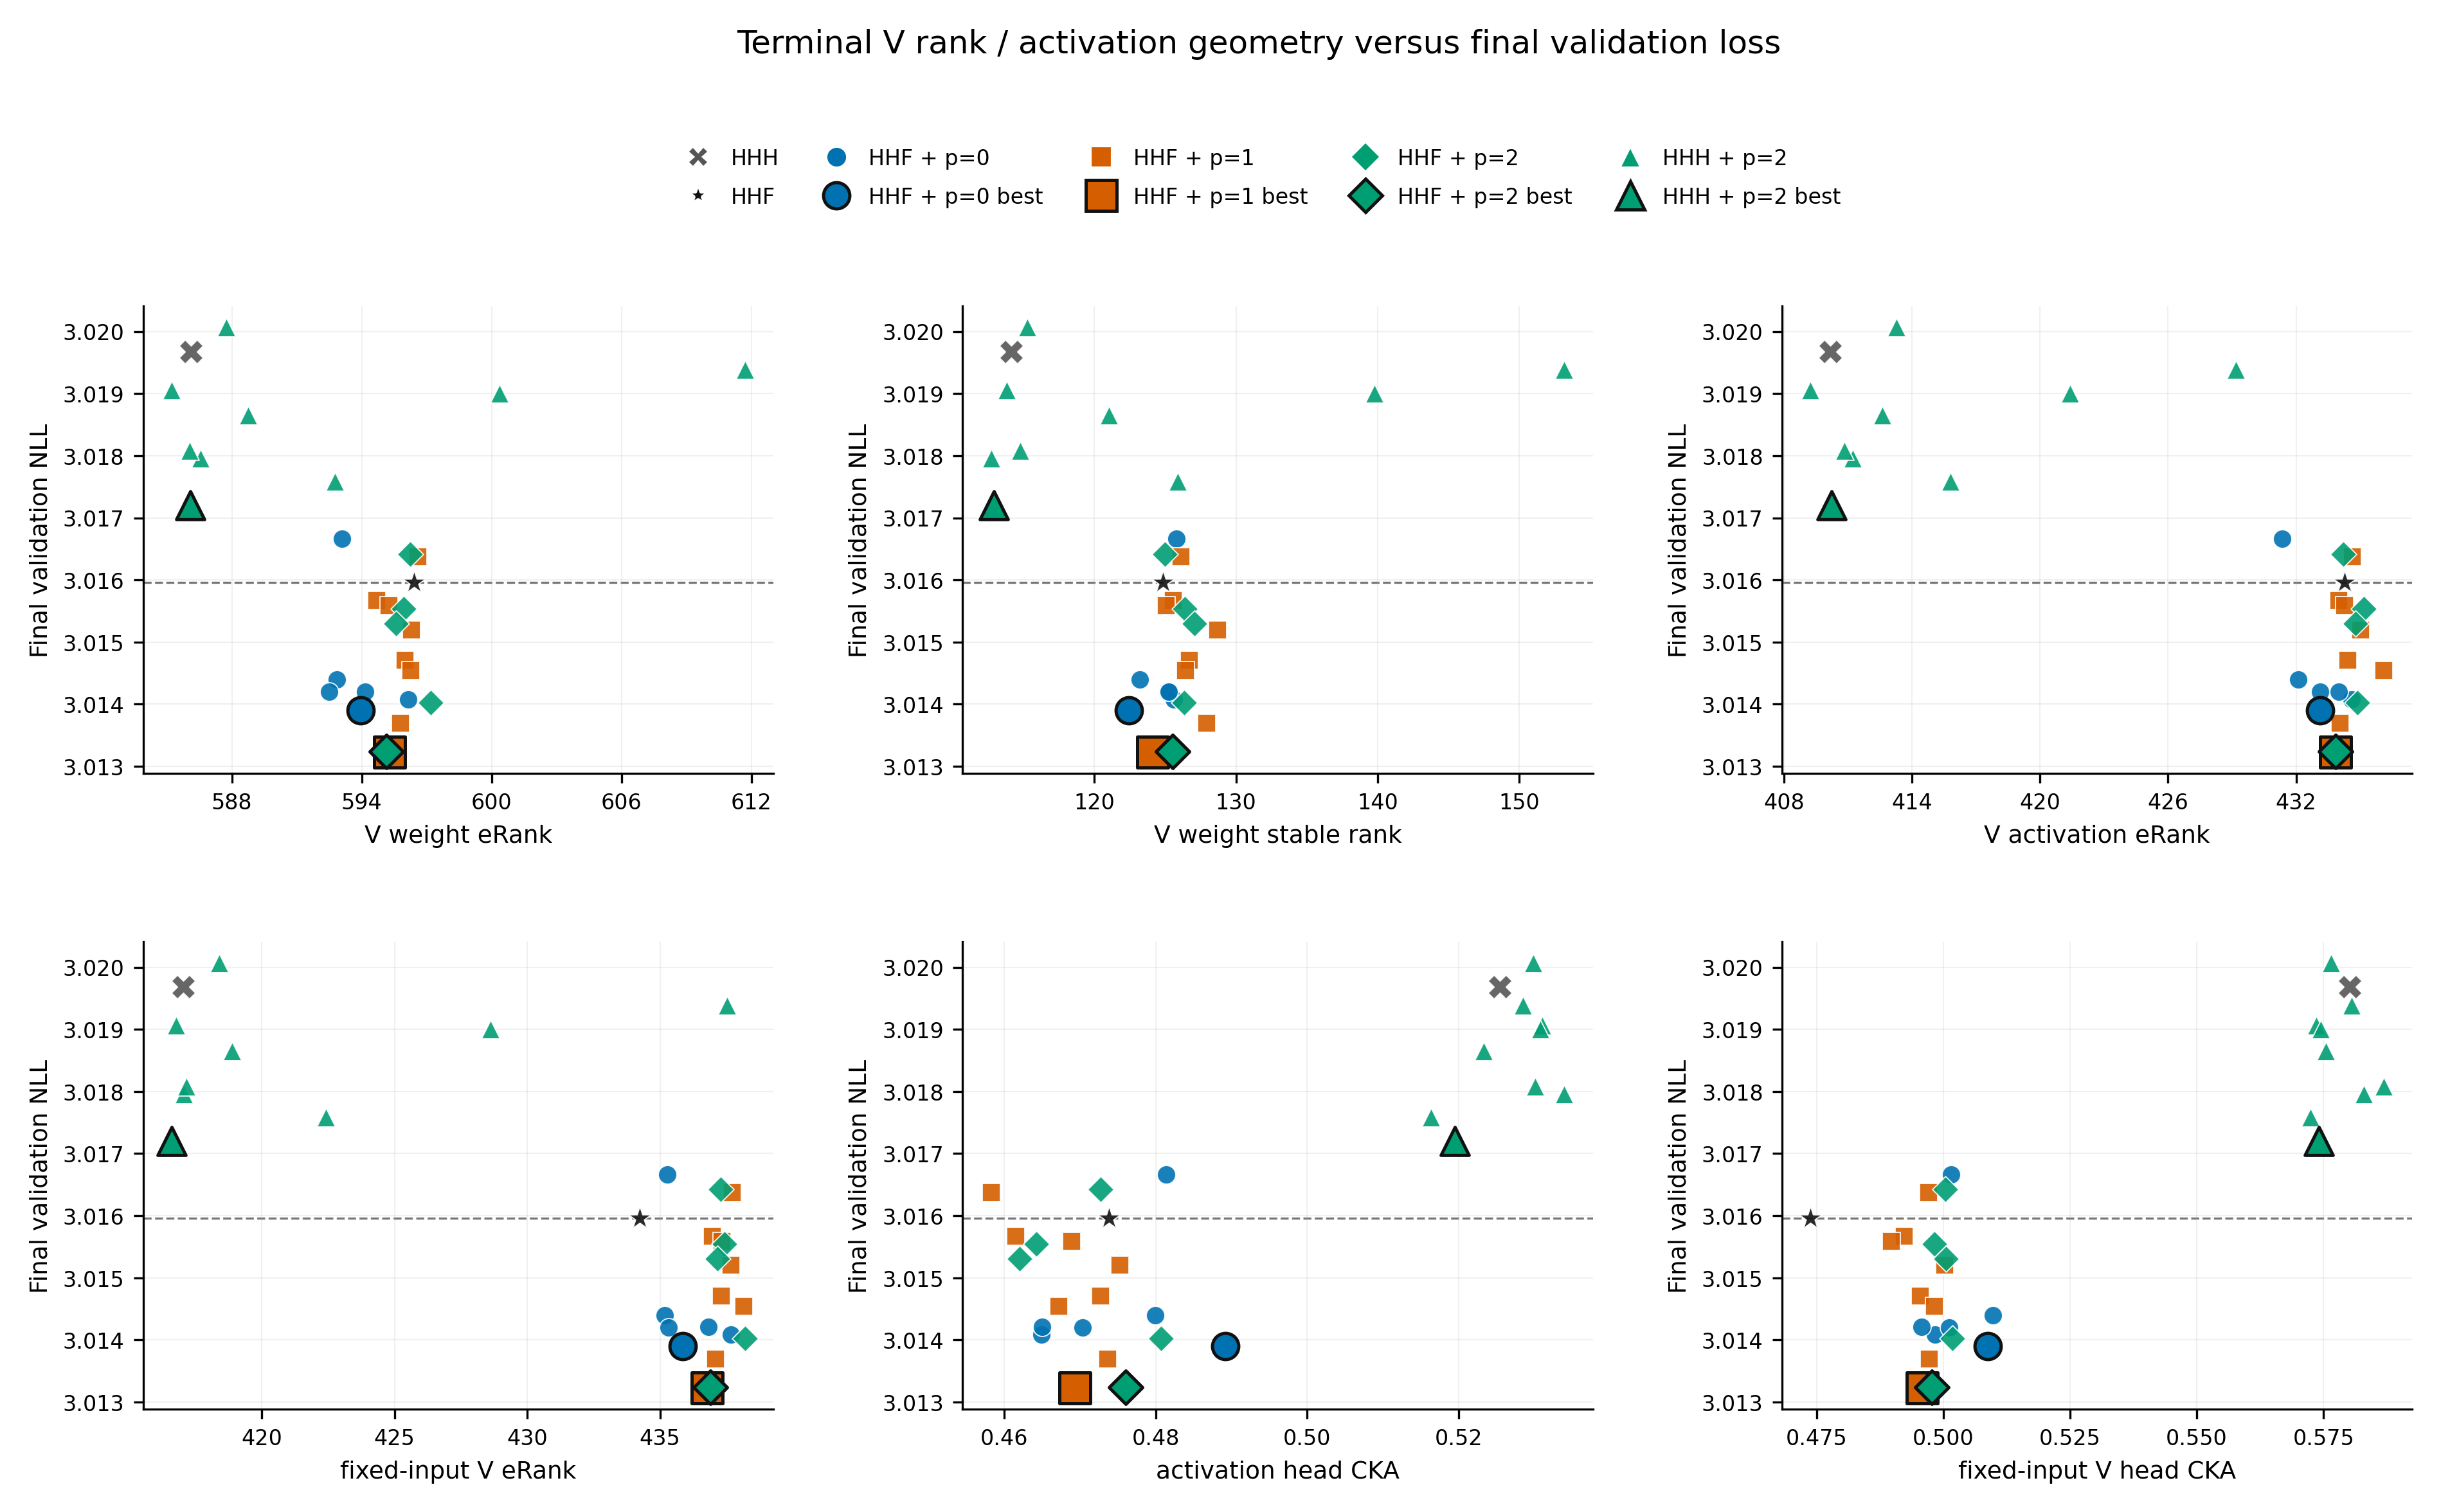
图 9:终点 V 几何与最终验证 NLL。上排为权重 eRank、权重稳定秩和实际激活 eRank;下排为固定输入下的激活 eRank、实际激活的跨 head CKA 和固定输入下的跨 head CKA。秩未除以维度。叉号和星号表示 HHH、HHF;圆形、方形、菱形表示 HHF 上的 扫描;三角形表示 HHH + 。粗边框标出各组的最佳点,虚线为 HHF 对照的损失。
从 HHH 到 HHF,区别更清楚地体现在 V 的内容表示上。 实际激活 eRank 从约 升至 ,跨 head CKA 从约 降至 ;固定输入下,也同时出现 eRank 升高与 CKA 降低。这说明,在抽样输入上,HHF 的内容响应分布于更多有效方向,head 之间的统计重叠也更少。这与一种可能的解释相符:完整 V 更新有助于学到更互补的内容特征,减少逐 head 更新下可能出现的表示冗余。固定输入结果进一步说明,差异也存在于 V 映射本身,并非完全来自上游输入变化。
图中还有一个有意思的对照:有些 HHH + 运行的权重 eRank 或稳定秩已高于 HHF,损失却仍更高。因此,HHF 的优势更适合从“学到了怎样的内容表示”来理解:联合激活的有效方向、head 之间的互补性,以及任务对这些方向的利用,共同构成了比权重秩更完整的解释。这也呼应了近期 Muon 研究对谱形状与任务表现之间关系的讨论 (Goyal & Ramkumar, 2026)。
在 HHF 内部,谱衰减还带来了更细致的表示调节。 实际激活 eRank 的点云几乎竖直展开:有效维度接近,损失却有差别。最佳 点相对 HHF 对照,权重 eRank 略低,实际激活 eRank 基本不变,固定输入下的 eRank 略高,两种 CKA 也都更高。这说明,相近的有效维度也能对应不同的内容组织方式和任务表现。
对照的最佳点与最佳 点也非常接近。这让 V 正则化成为一个更值得单独调节的部分:普通衰减的系数已经能带来收益,而谱幂进一步允许我们选择模态间的收缩分配。这里更有意思的问题,是怎样让这份额外的自由度与内容表示的需求相配合。
Rank 与 CKA 如何测量
权重秩在完整 V 矩阵上计算。实际激活秩使用各层抽样并中心化后的 V 输出,因此包含该检查点自身的上游表示。固定输入测量则将每个检查点的 V 权重作用于 HHF 对照的对应层输入。图中的秩均对 12 层取平均。
对两个中心化的 head 输出 ,线性 CKA 为
先对六个 head 的 15 对 CKA 取平均,再对 12 层平均 (Kornblith et al., 2019)。CKA 更高表示这一统计下的表示更相似。固定输入比较保持抽样输入不变,帮助我们区分 V 映射本身的变化与上游变化。
我们猜想,完整 V 更新与谱衰减可以从两个方面改善有效表示容量:前者联合处理不同 head 的更新方向,帮助它们学习互补内容;后者调整模态之间的相对大小,让任务更新更充分地利用表示空间。例如, 抑制过度主导的大模态、保留中尾部的相对贡献,可能让同样的参数承载更丰富的有效表示。这种容量既体现在有效方向的数量,也体现在跨 head 的分工和信息分配上。下一个实验继续追问:如果最终验证损失几乎相同,这些内部结构还能相差多少?
5. 案例二:预训练损失接近,秩结构不同
5.1 按模块选择谱偏好
我们比较普通 WD 与一种分别为 Attention、MLP 设置幂次的非对称配方,再寻找最终验证损失接近的运行。
Attention 在 token 之间混合信息,MLP 则在每个 token 内变换特征。可以据此尝试不同的谱偏好:Attention 取 ,对弱模态施加更强的相对衰减;MLP 取 ,减弱大模态的主导性。这个实验受到低秩 attention 分析和模块级衰减分配的启发 (He et al., 2025; Kobayashi et al., 2024),并不预设某个模块存在普遍最优的秩。
两组都用 Muon 更新矩阵参数,采用独立系数约定: 乘任务与衰减两项, 不再额外乘 ,也不叠加普通 WD。因此,这里的系数不能直接与第 4 节的 LR-coupled 数值比较。
基线取 ,非对称配方取 ,其中 分别表示 Attention 和 MLP。两组都允许单独调整模块系数,并使用相同的基础学习率与衰减系数网格:
每组有 个配置,共 54 个。下面比较其中最终验证损失最接近的两个运行。它们共享模型、初始化、随机种子、有序数据流和验证数据,均训练 7,268 步,基础学习率均为 :
| Run | Attention | MLP | 学习率末段衰减前 loss | 最终 validation loss |
|---|---|---|---|---|
| Ordinary-WD baseline | 3.107320711 | 3.000562422 | ||
| Asymmetric | 3.109563260 | 3.000577086 |
最终损失相差约 nats。
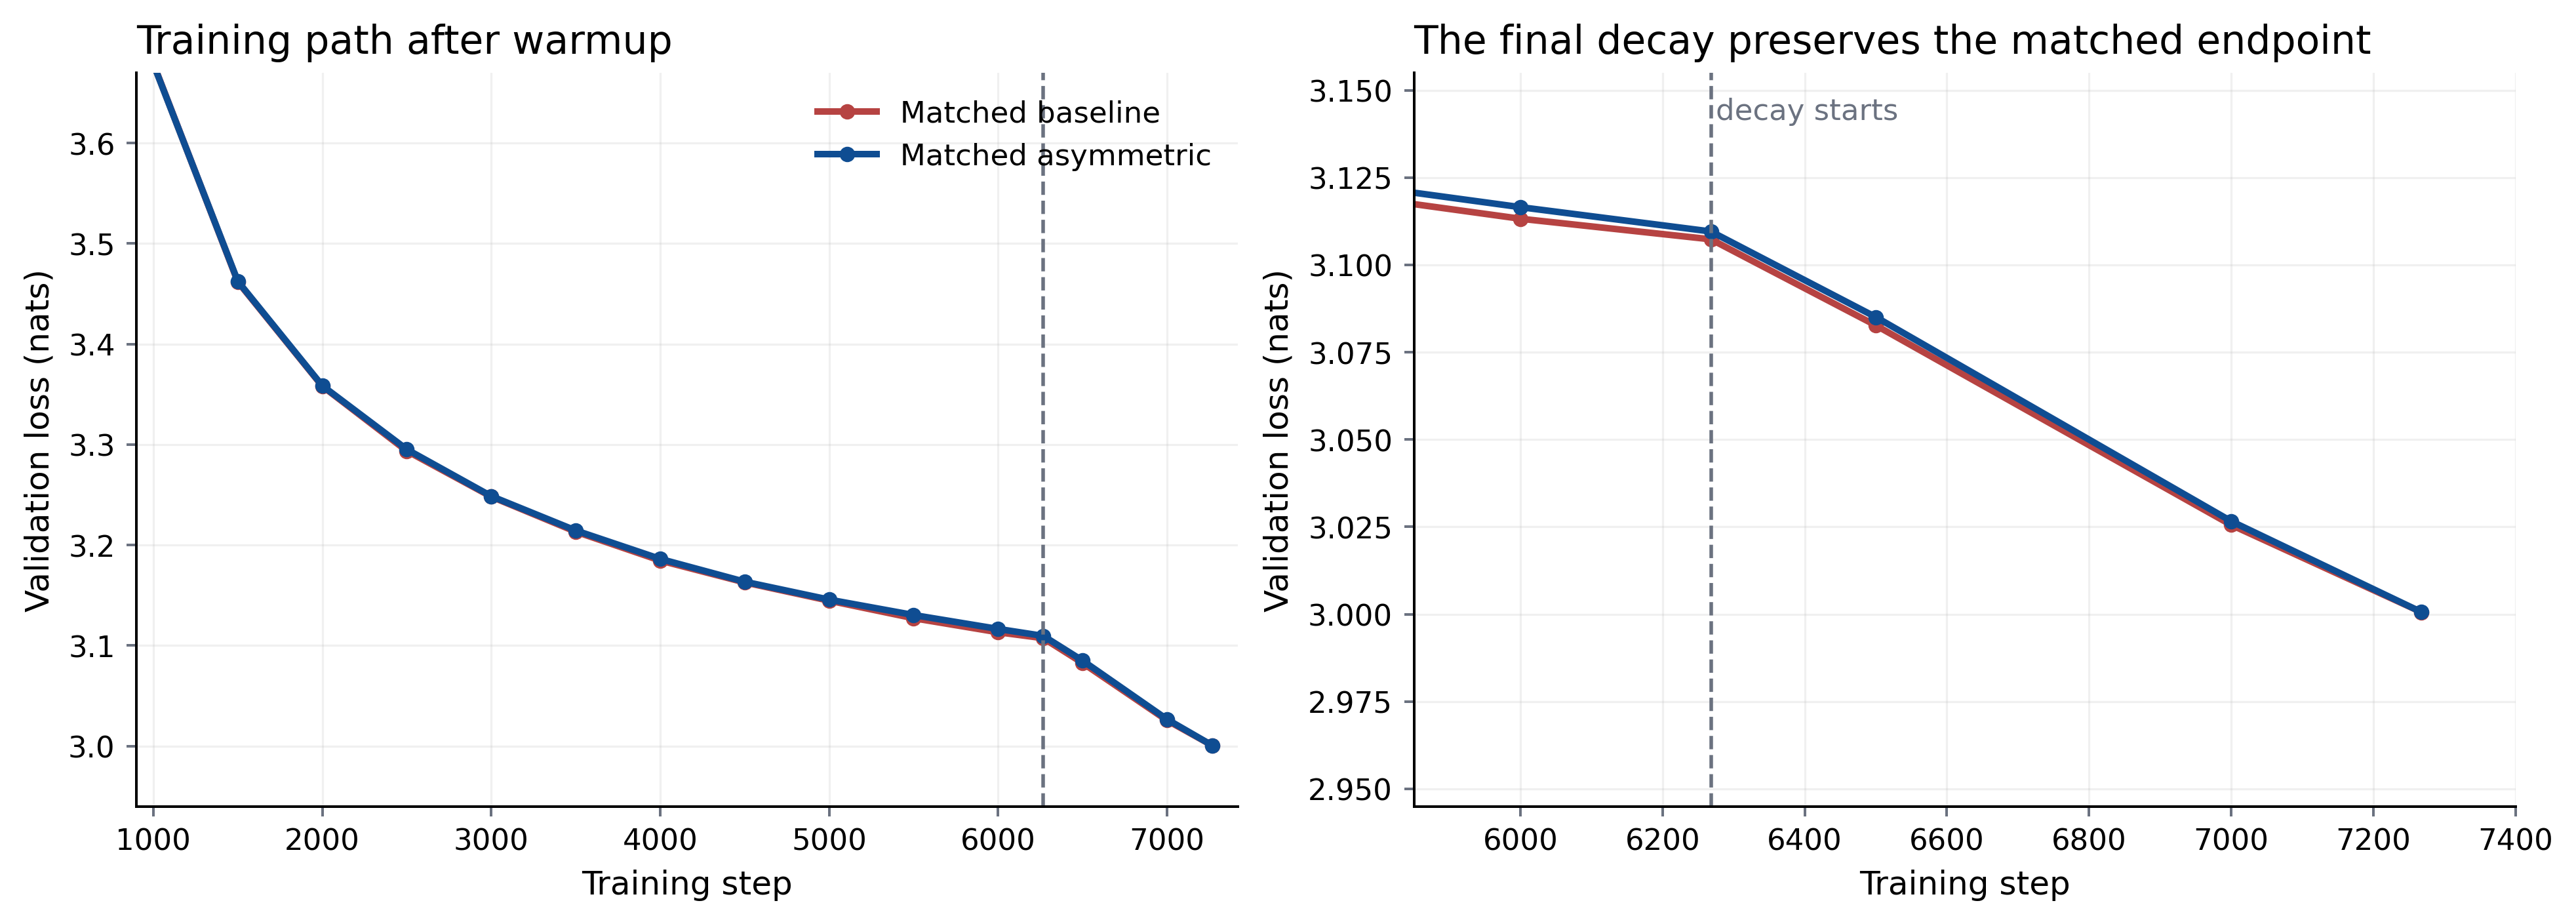
图 10:所选普通 WD 与非对称运行的验证轨迹。左图为预热后的训练,右图放大最终学习率衰减阶段附近的窗口,虚线标出该阶段的起点。两次运行均在第 7,268 步结束。
两条轨迹在最终评估之前就已经很接近。末段学习率衰减前,损失相差约 nats,训练结束时进一步缩小。接近的拟合结果,让下面的内部几何对比更有意思。
5.2 损失接近,内部几何仍有明显差别
| 权重或乘积指标 | Ordinary baseline | Asymmetric |
|---|---|---|
| Attention spectral norm | 3.3083 | 4.6478 |
| Attention stable rank | 89.90 | 78.75 |
| Attention entropy eRank | 587.03 | 565.05 |
| MLP spectral norm | 6.1150 | 4.1062 |
| MLP stable rank | 184.28 | 258.61 |
| MLP entropy eRank | 729.97 | 743.00 |
| QK product stable rank | 15.57 | 17.06 |
在这对运行中,非对称衰减使 Attention 权重谱更集中、MLP 稳定秩更高,大体符合设计时的偏好。这里权重统计中的“Attention”指投影权重,而不是 softmax 后的注意力图。与此同时,QK 乘积的稳定秩反而上升。乘积谱不仅取决于因子的奇异值,还取决于奇异向量之间的对齐,因此因子秩较低,并不一定对应更低的乘积稳定秩。
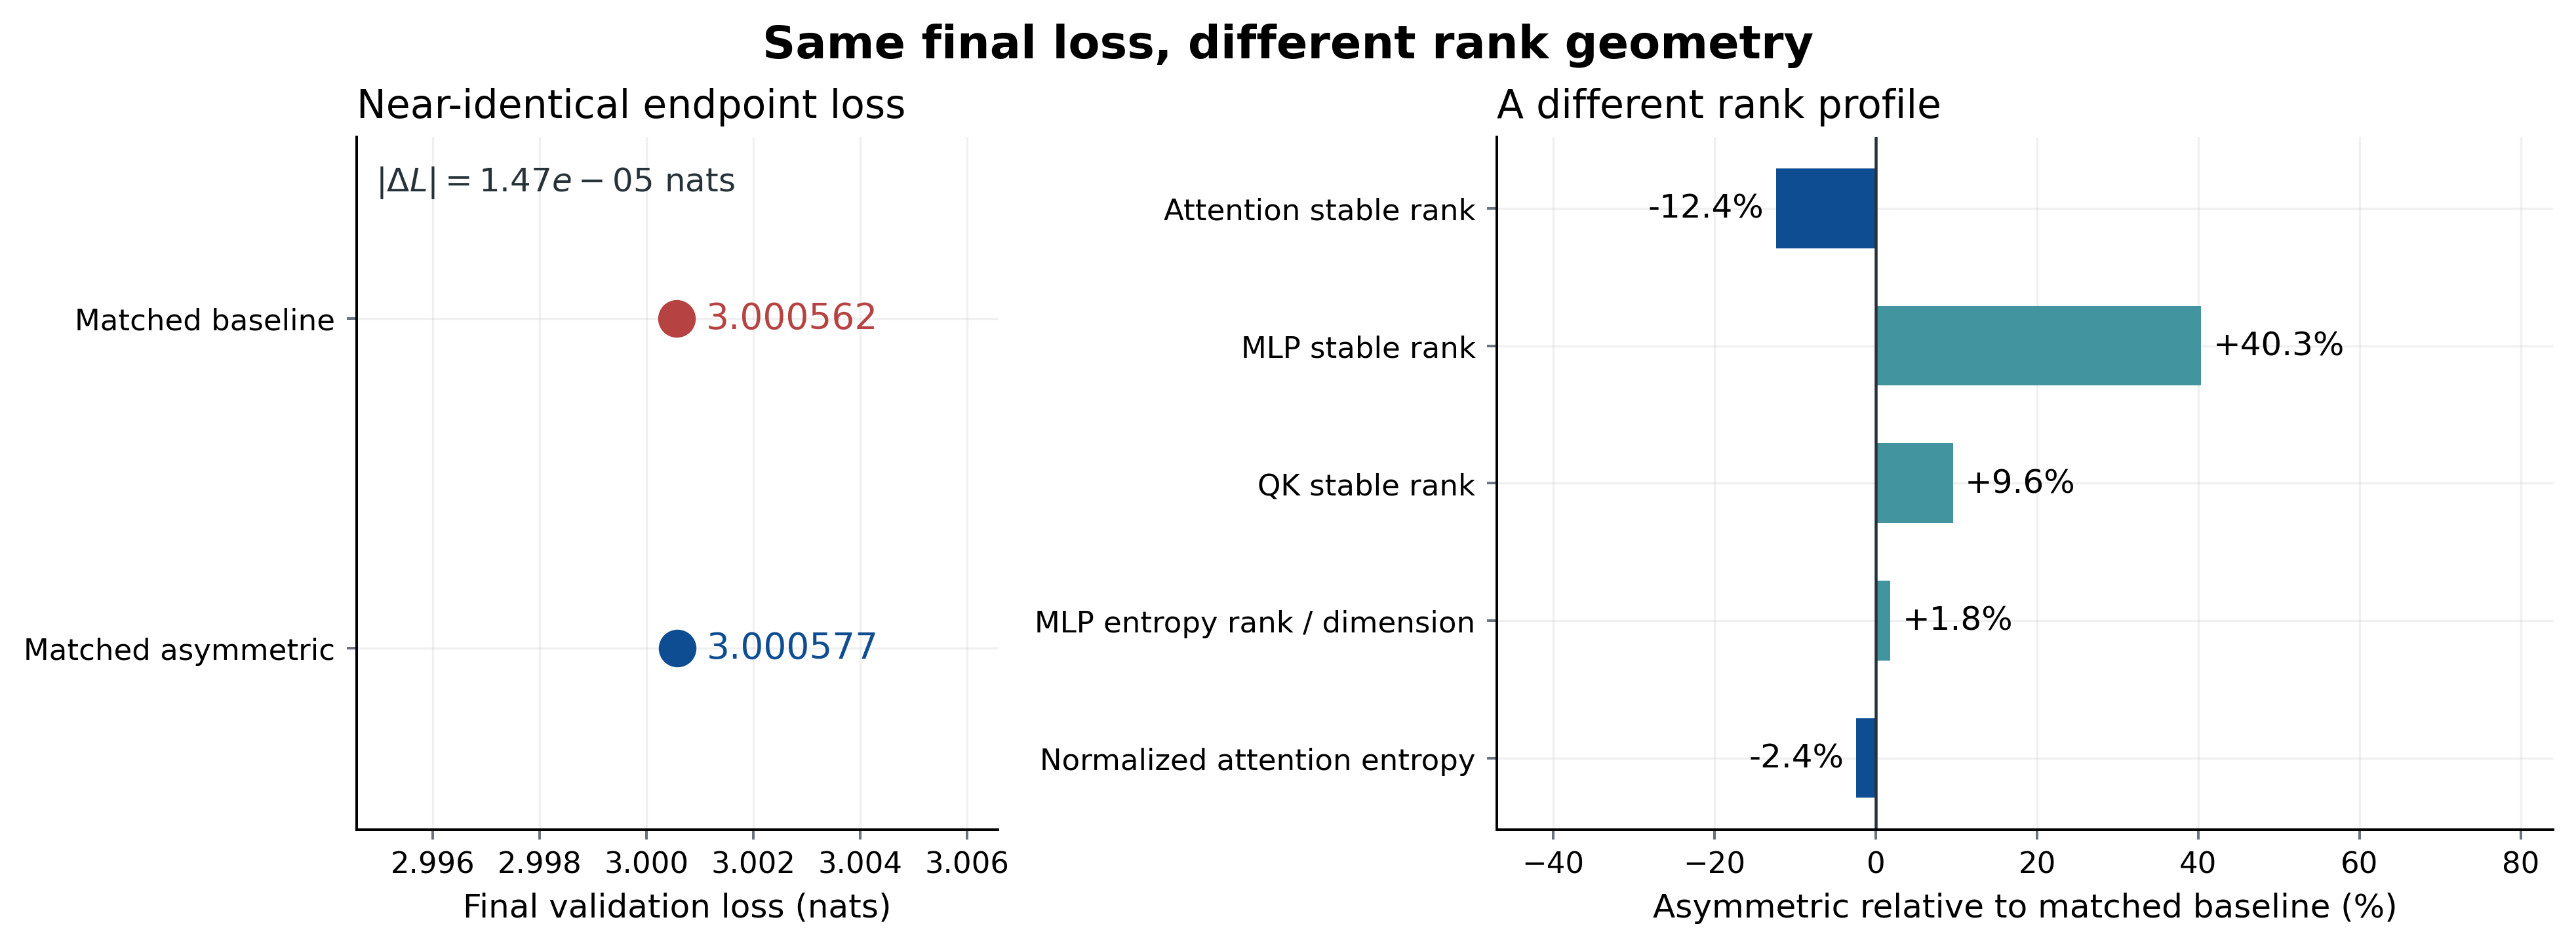
图 11:最终验证损失近似匹配时的几何差异。右图给出相对普通 WD 基线的变化:Attention 权重稳定秩、MLP 权重稳定秩、QK 乘积稳定秩、按维度归一化的 MLP eRank,以及归一化注意力熵。
MLP 稳定秩上升了 40.3%,按维度归一化的 eRank 却只上升了 1.8%。两者强调的是不同特征:前者对最大奇异值尤其敏感,后者概括所有模态的分布。因此,将结果描述为“相对谱集中程度发生明显变化”,比直接说“表示维度增加了 40%”更合适。
对应的前向测量也有差异。从普通 WD 到非对称衰减,归一化注意力熵由 降至 ,平均最大注意力概率由 升至 ;Q 激活 RMS 由 升至 ,MLP 输出 RMS 由 降至 。可见,几乎相同的平均验证损失,仍可以对应不同的注意力分布与内部尺度。
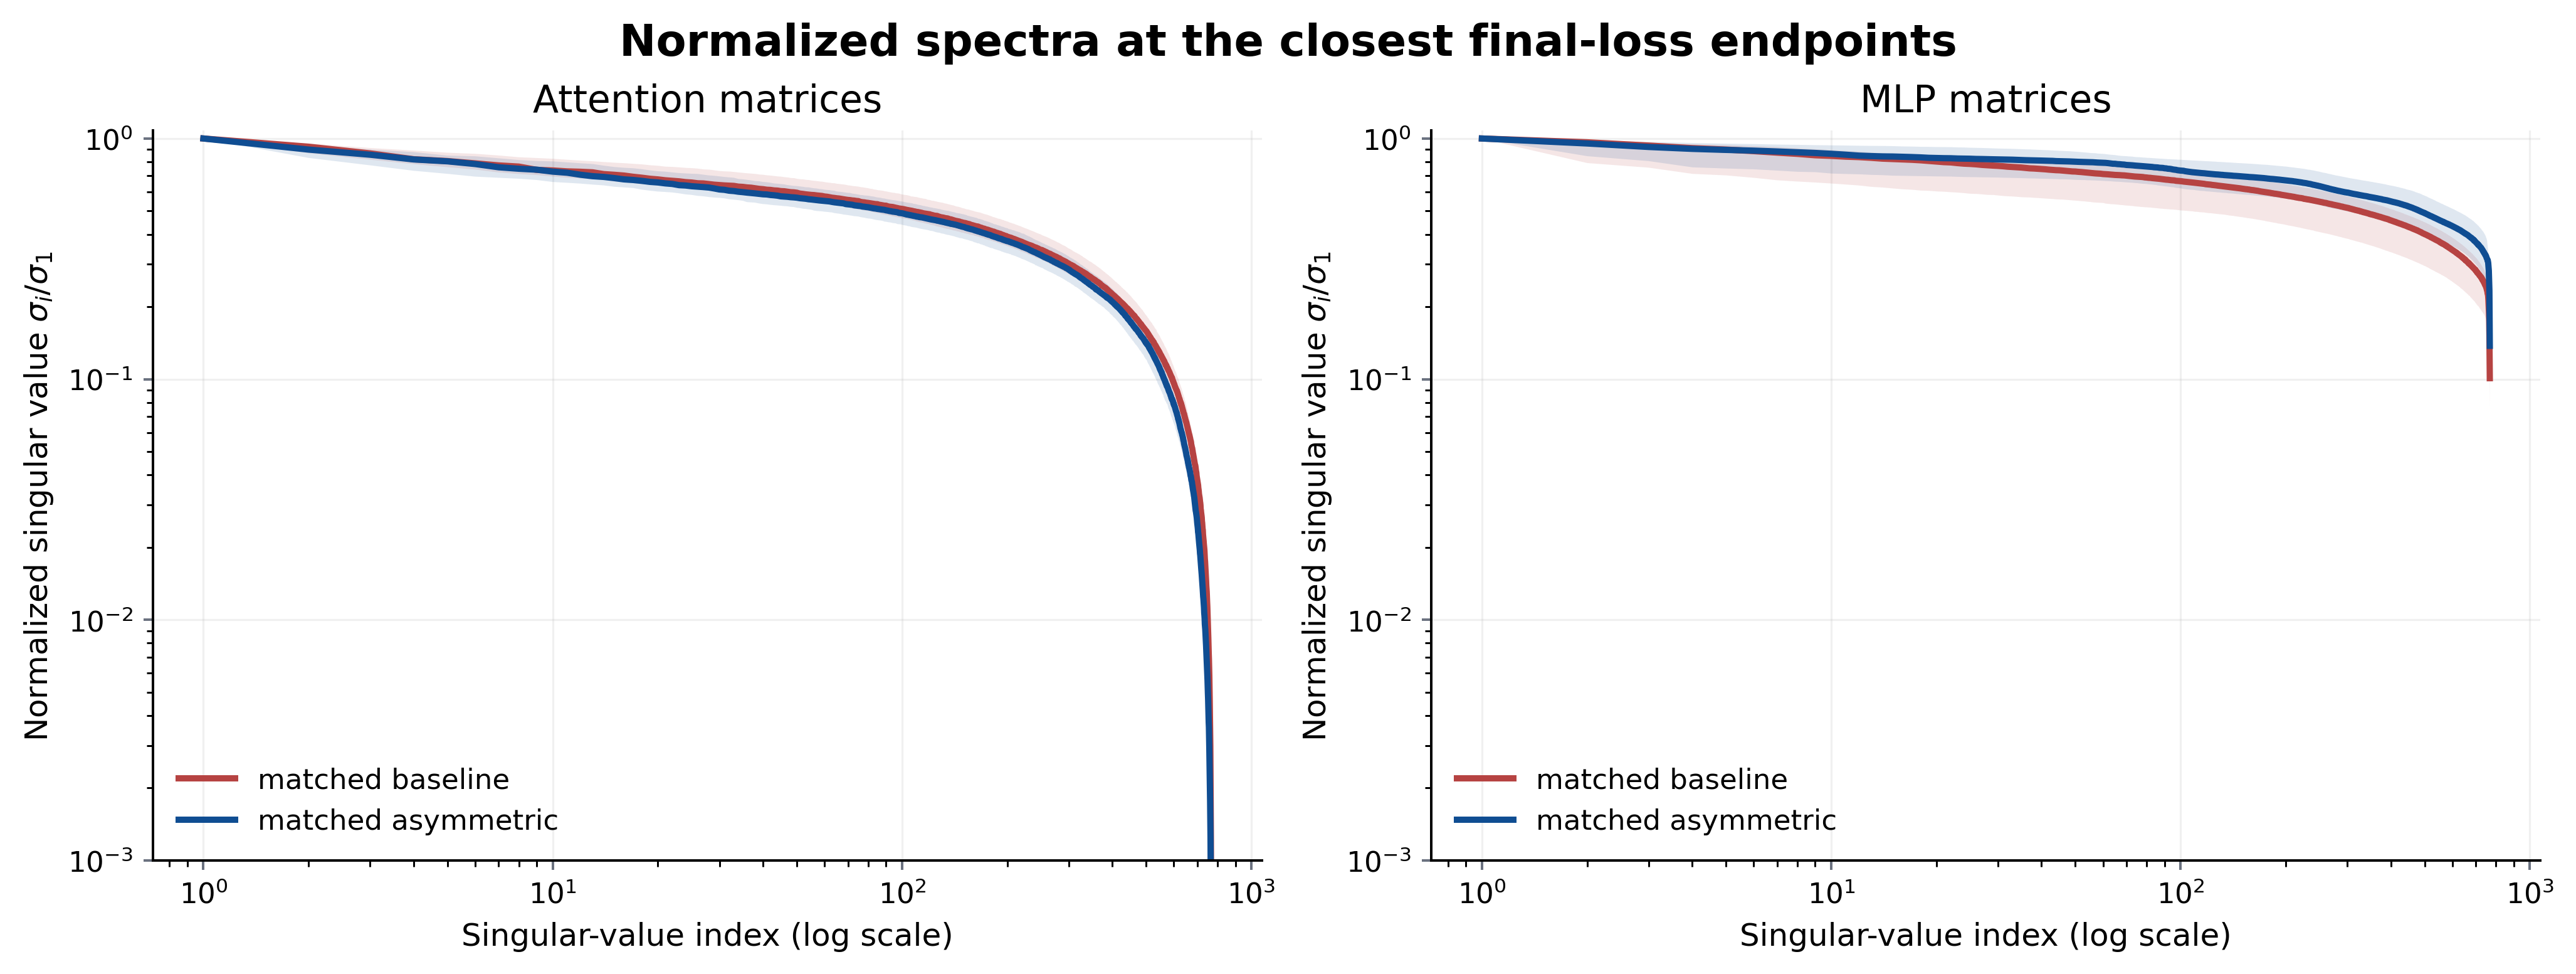
图 12:所选终点的归一化权重谱。Attention 投影谱更集中,MLP 谱则更平坦;表中的范数给出相应的绝对尺度比较。
横轴取对数后,主导模态更加醒目,大部分中尾部模态却被压缩在较小的显示区间内。许多模态上看起来不大的曲线间距,仍可能明显影响稳定秩,因为它对所有序号上的 直接求和,并不按对数坐标加权。归一化曲线也隐藏了一个尺度差别:非对称运行的 Attention 谱范数更大,MLP 谱范数则更小。
这对运行在接近的预训练损失下,保留了不同的内部谱与激活统计。谱衰减因而提供了一种有意思的调节方式:在维持近似相同拟合表现的同时,探索不同的信息分配与表示结构,并进一步比较它们在迁移、微调和鲁棒性上的表现。
6. 相关扩展:把谱投影放进衰减分支
幂律会改变整个谱上的收缩规律,也可以进一步选择哪些模态参与衰减。最近一项工作利用平移后的 Gram 矩阵和对称矩阵符号函数,选择阈值以上或以下的动量子空间 (Goyal & Ramkumar, 2026)。将同样的构造用于权重,就能得到谱带选择性衰减,而不改变任务优化器。
构造投影。 先取 、,选择奇异值阈值 ,并假设没有奇异值恰好等于它。令 ,构造
其中 是单位矩阵。对称矩阵符号函数保留特征向量,将每个特征值替换为其符号:若 ,则 。由于 ,正、负特征子空间恰好对应阈值以上和以下的模态, 就是相应的投影。
原论文将这个操作用于动量矩阵 ,从 构造 。记 ,两种任务方向为
被选中的子空间采用 polar 方向,另一侧保留原始动量。用于权重衰减时,类似的混合规则是在一侧施加 ,另一侧保留普通 WD:
也可以不衰减未选中的子空间。为区别于上面的混合规则,记为
不用 SVD 计算投影。 将平移后的对称矩阵归一化为 ,再应用收敛的五次 Newton–Schulz 迭代
这个奇多项式保留特征值的符号,并将非零模态推向 。先构造 ,就能复用 。靠近阈值的模态对应接近零的特征值,需要更多迭代才能分辨;原论文在 NanoGPT 中对两次 sign 调用都使用了 20 次 FP32 迭代 (Goyal & Ramkumar, 2026)。有限迭代下得到的是近似投影,而非精确的二值选择器,精度取决于阈值附近的谱间隔。
对应的逐模态更新。 单独做谱头选择性衰减,按当前奇异方向标记模态,并取足够小的步长以保持模态系数非负,有
连续时间下,对应的纯衰减规律是 。阈值决定选哪些模态,幂次决定收缩规律,系数决定强度。每步根据当前 重算投影,还可以为两个子空间分别设置幂次和系数。对 ,
任一系数设为零,就只衰减一个谱带;两侧幂次都取 1、系数相等,则恢复普通 WD。 时,改用 ,将相应投影放在左侧相乘,与第 3.2 节的处理一致。
这个扩展将两个选择分开了:哪些模态需要正则化,以及收缩强度如何随模态大小变化。构造本身只规定衰减规则,它在训练中的作用还需要实验检验。
7. 结语
普通 WD 在单独的衰减步中等比例缩小所有奇异值。 WD 用一个幂次改变这条规则: 相对更强地压低弱模态, 相对更强地压低强模态。线性模型给出了精确的结果,八层 Transformer 则说明,这种效应在任务驱动的训练后仍然可以观察到。
两个案例展示了这种调节的具体用途。在 V 实验中,完整矩阵更新学到了更分散、跨 head 重叠更少的内容表示,进一步调整正则化又改善了默认 HHF 配方。在非对称实验中,近似匹配的验证损失仍对应明显不同的权重谱和激活统计。这些结果让我们可以进一步探索:怎样分配模态之间的大小与作用,才能更充分地利用模型的有效表示容量?
这为正则化增加了一种可检验的选择:不再完全依靠优化器与标量衰减共同决定谱形状,而是明确指定希望施加的谱偏好。幂次、系数、模块分配和谱带选择,提供了逐步细化的调节方式。哪些选择有用,取决于任务和训练条件。ORCA 的阶段性谱正则化 (Y. Liu et al., 2026),以及 S²D 面向量化的谱衰减 (Chavan et al., 2026),也给出了可以继续研究的具体场景。
谱塑形还可能成为改善训练稳定性的工具。已有工作通过谱范数重参数化缓解 attention entropy collapse,并改善 Transformer 的训练稳定性 (Zhai et al., 2023)。我们猜想, 或谱带选择可以对异常放大的模态施加更有针对性的衰减,从而有机会控制谱范数增长、减少 loss spikes,并拓宽稳定的学习率区间。
Weight decay 不必让每个模态按相同比例收缩。选择不同的收缩规律,让我们能够主动调节谱;这种调节是否有用,最终仍要看任务表现。
- Amsel, N., Persson, D., Musco, C., & Gower, R. M. (2026). The Polar Express: Optimal Matrix Sign Methods and their Application to the Muon Algorithm. The Fourteenth International Conference on Learning Representations. https://openreview.net/forum?id=yRtgZ1K8hO back: 1, 2, 3
- Andriianov, D., Veprikov, A., & Beznosikov, A. (2026). Spectral Weight Decay: Inducing Low-Rank Structure in Neural Network Weights. https://arxiv.org/abs/2610.11730
- Cai, J.-F., Candès, E. J., & Shen, Z. (2010). A Singular Value Thresholding Algorithm for Matrix Completion. SIAM Journal on Optimization, 20(4), 1956–1982. 10.1137/080738970 back: 1, 2, 3, 4
- Chavan, A., Lele, N., Bamba, U., Dayal, S., Raghunathan, A., & Gupta, D. (2026). S2D: Selective Spectral Decay for Quantization-Friendly Conditioning of Neural Activations. https://arxiv.org/abs/2602.14432
- DeepSeek-AI. (2026). DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression. arXiv Preprint arXiv:2609.19969. https://arxiv.org/abs/2609.19969
- Duchi, J., Hazan, E., & Singer, Y. (2011). Adaptive Subgradient Methods for Online Learning and Stochastic Optimization. Journal of Machine Learning Research, 12(61), 2121–2159. http://jmlr.org/papers/v12/duchi11a.html
- Eckart, C., & Young, G. (1936). The approximation of one matrix by another of lower rank. Psychometrika, 1, 211–218. 10.1007/BF02288367
- Ghiasi, A., Shafahi, A., & Ardekani, R. (2023). Improving Robustness with Adaptive Weight Decay. Thirty-Seventh Conference on Neural Information Processing Systems. https://openreview.net/forum?id=ajnThDhuq6
- GLM-5 Team. (2026). GLM-5: From Vibe Coding to Agentic Engineering. arXiv Preprint arXiv:2602.15763. https://arxiv.org/abs/2602.15763
- Goyal, V., & Ramkumar, R. (2026). Spectrally Targeted Muon. https://arxiv.org/abs/2610.10965 back: 1, 2, 3
- Gupta, V., Koren, T., & Singer, Y. (2018). Shampoo: Preconditioned Stochastic Tensor Optimization. Proceedings of the 35th International Conference on Machine Learning. https://proceedings.mlr.press/v80/gupta18a.html
- He, D., Tu, S., Jaiswal, A., Shen, L., Yuan, G., Liu, S., & Yin, L. (2025). AlphaDecay: Module-wise Weight Decay for Heavy-Tailed Balancing in LLMs. https://arxiv.org/abs/2506.14562 back: 1, 2
- Higham, N. J. (1986). Computing the Polar Decomposition—with Applications. SIAM Journal on Scientific and Statistical Computing, 7(4), 1160–1174. 10.1137/0907079
- Higham, N. J. (2002). Accuracy and Stability of Numerical Algorithms (2nd ed.). 10.1137/1.9780898718027
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics, 12(1), 55–67. 10.1080/00401706.1970.10488634
- Jordan, K., Jin, Y., Boza, V., You, J., Cesista, F., Newhouse, L., & Bernstein, J. (2024). Muon: An optimizer for hidden layers in neural networks. https://kellerjordan.github.io/posts/muon/ back: 1, 2
- Kessy, A., Lewin, A., & Strimmer, K. (2018). Optimal Whitening and Decorrelation. The American Statistician, 72(4), 309–314. 10.1080/00031305.2016.1277159
- Kimi Team. (2026). Kimi K3: Open Frontier Intelligence. arXiv Preprint arXiv:2607.24653. https://arxiv.org/abs/2607.24653
- Kingma, D. P., & Ba, J. (2015). Adam: A Method for Stochastic Optimization. International Conference on Learning Representations. https://arxiv.org/abs/1412.6980
- Kobayashi, S., Akram, Y., & von Oswald, J. (2024). Weight Decay Induces Low-Rank Attention Layers. Advances in Neural Information Processing Systems 37. https://arxiv.org/abs/2410.23819 back: 1, 2
- Kornblith, S., Norouzi, M., Lee, H., & Hinton, G. (2019). Similarity of Neural Network Representations Revisited. Proceedings of the 36th International Conference on Machine Learning, 97, 3519–3529. https://proceedings.mlr.press/v97/kornblith19a.html
- Krogh, A., & Hertz, J. A. (1991). A Simple Weight Decay Can Improve Generalization. Advances in Neural Information Processing Systems, 4. https://papers.neurips.cc/paper_files/paper/1991/hash/8eefcfdf5990e441f0fb6f3fad709e21-Abstract.html
- Lewis, A. S. (1995). The Convex Analysis of Unitarily Invariant Matrix Functions. Journal of Convex Analysis, 2(1–2), 173–183. 10.68381/jca02012 back: 1, 2, 3
- Liu, J., Su, J., Yao, X., Jiang, Z., Lai, G., Du, Y., Qin, Y., Xu, W., Lu, E., Yan, J., Chen, Y., Zheng, H., Liu, Y., Liu, S., Yin, B., He, W., Zhu, H., Wang, Y., Wang, J., … Yang, Z. (2025). Muon is Scalable for LLM Training. https://arxiv.org/abs/2502.16982
- Liu, Y., Jiang, B., Hou, L., Tao, X., Wan, P., Lin, Z., & Fang, C. (2026). ORCA: The Annealed Spectral Conditioning Optimizer for Faster, Better LLM Training. https://arxiv.org/abs/2610.06116
- Loshchilov, I., & Hutter, F. (2019). Decoupled Weight Decay Regularization. International Conference on Learning Representations. https://openreview.net/forum?id=Bkg6RiCqY7 back: 1, 2
- Martens, J., & Grosse, R. (2015). Optimizing Neural Networks with Kronecker-factored Approximate Curvature. Proceedings of the 32nd International Conference on Machine Learning, 2408–2417. https://proceedings.mlr.press/v37/martens15.html
- Nakamura, K., & Hong, B.-W. (2019). Adaptive Weight Decay for Deep Neural Networks. https://arxiv.org/abs/1907.08931
- Parikh, N., & Boyd, S. (2014). Proximal Algorithms. Foundations and Trends in Optimization, 1(3), 123–231. https://web.stanford.edu/~boyd/papers/prox_algs.html back: 1, 2
- Qiu, Z., Wang, Z., Li, X., Li, Y., Xu, Y., Wang, Y., Zhang, H., Men, R., Mao, B., Zhang, C., Zhou, F., Luo, H., Huang, H., Lian, H., Huang, H., Chen, H., Zhang, J., Xu, J., Wang, J., … Liu, D. (2026). On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability. https://arxiv.org/abs/2608.30320
- Roy, O., & Vetterli, M. (2007). The Effective Rank: A Measure of Effective Dimensionality. 15th European Signal Processing Conference, 606–610. https://eurasip.org/Proceedings/Eusipco/Eusipco2007/Papers/a5p-h05.pdf back: 1, 2, 3
- Sanyal, A., Torr, P. H. S., & Dokania, P. K. (2020). Stable Rank Normalization for Improved Generalization in Neural Networks and GANs. International Conference on Learning Representations. https://openreview.net/forum?id=H1enKkrFDB
- Shannon, C. E. (1948). A Mathematical Theory of Communication. The Bell System Technical Journal, 27(3), 379–423. 10.1002/j.1538-7305.1948.tb01338.x
- Srebro, N., Rennie, J. D. M., & Jaakkola, T. S. (2004). Maximum-Margin Matrix Factorization. Advances in Neural Information Processing Systems, 17, 1329–1336. https://proceedings.neurips.cc/paper/2004/hash/e0688d13958a19e087e123148555e4b4-Abstract.html
- Sutskever, I., Martens, J., Dahl, G., & Hinton, G. (2013). On the importance of initialization and momentum in deep learning. Proceedings of the 30th International Conference on Machine Learning, 28(3), 1139–1147. https://proceedings.mlr.press/v28/sutskever13.html
- Tang, X., Zhang, H., Cao, Y., & Zou, D. (2025). Understanding the Generalization of Stochastic Gradient Adam in Learning Neural Networks. Advances in Neural Information Processing Systems, 38. 10.52202/085713-0612
- Tikhonov, A. N., & Arsenin, V. Y. (1977). Solutions of Ill-Posed Problems. Winston. https://catalog.library.tamu.edu/Record/in00000360774/Details
- van Laarhoven, T. (2017). L2 Regularization versus Batch and Weight Normalization. https://arxiv.org/abs/1706.05350
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems, 30. https://arxiv.org/abs/1706.03762 back: 1, 2
- Vyas, N., Morwani, D., Zhao, R., Kwun, M., Shapira, I., Brandfonbrener, D., Janson, L., & Kakade, S. (2025). SOAP: Improving and Stabilizing Shampoo using Adam. https://arxiv.org/abs/2409.11321
- Watson, G. A. (1992). Characterization of the subdifferential of some matrix norms. Linear Algebra and Its Applications, 170, 33–45. 10.1016/0024-3795(92)90407-2 back: 1, 2, 3
- Wen, K., Dang, X., Lyu, K., Ma, T., & Liang, P. (2026). Fantastic Pretraining Optimizers and Where to Find Them II: Hyperball Optimization. https://arxiv.org/abs/2606.16899
- Zhai, S., Likhomanenko, T., Littwin, E., Busbridge, D., Ramapuram, J., Zhang, Y., Gu, J., & Susskind, J. M. (2023). Stabilizing Transformer Training by Preventing Attention Entropy Collapse. Proceedings of the 40th International Conference on Machine Learning, 202, 40770–40803. https://proceedings.mlr.press/v202/zhai23a.html back: 1, 2
- Zhang, G., Wang, C., Xu, B., & Grosse, R. (2019). Three Mechanisms of Weight Decay Regularization. International Conference on Learning Representations. https://arxiv.org/abs/1810.12281
- Zou, D., Cao, Y., Li, Y., & Gu, Q. (2023). Understanding the Generalization of Adam in Learning Neural Networks with Proper Regularization. International Conference on Learning Representations. https://openreview.net/forum?id=iUYpN14qjTF